
Au cours de la dernière décennie, la plupart des équipes data ont fini par adopter une approche commune de la collecte et du stockage des données : récupérer les données aux quatre coins de l’entreprise, les centraliser dans un entrepôt de données, les transformer en modèles clairement définis, vérifier leur qualité et les rendre disponibles pour l’analyse. Résultat : une source de vérité fiable, pilotée par une équipe data très technique, et qui recèle une valeur potentielle considérable.
Pourtant, malgré ces avancées, tirer des enseignements de cet Entrepôt de données si bien organisé reste étonnamment lent, et dans certaines organisations, les données ne créent que rarement une valeur concrète. C’est parce qu’avec cette pile technologique, passer des données (aussi bien organisées soient-elles) aux enseignements métier exige des compétences spécialisées en data : maîtriser SQL, avoir une carte mentale de l’Entrepôt de données, connaître le contexte métier et faire preuve de discernement analytique. En construisant un Entrepôt de données bien entretenu, nous avons bâti une forteresse à laquelle seules quelques personnes ont accès.
Résultat : les équipes data croulent sous une file d’attente interminable de demandes. Dans la plupart des organisations, seules les questions jugées « hautement prioritaires » ou populaires reçoivent une réponse dans les temps. Beaucoup d’autres restent sans réponse, et la plupart ne le seront jamais.
Chez Clay, on sait que lorsque des personnes qui ne sont pas spécialistes de la data mettent la main sur des données, elles posent de nouvelles questions et apportent de nouveaux points de vue, nourris par la diversité de leur expertise métier : la longue traîne peut receler une vraie valeur. Et quand tout le monde peut utiliser les données comme un data scientist, une culture data saine se développe naturellement, plutôt que d’être imposée et contrôlée. L’équipe data devient un moteur plutôt qu’un frein.
Alors, on a créé monty, un agent d’analyse développé en interne pour proposer de l’analyse en libre-service à grande échelle.
Découvrez monty, l’agent d’analyse en libre-service de Clay
monty est un agent d’analyse basé sur le framework eve de Vercel, qui utilise Opus pour l’inférence. Il peut interroger Snowflake directement, avec des autorisations volontairement limitées aux modèles de données approuvés. monty ne donne pas un accès sans restriction à l’entrepôt de données. Il fonctionne plutôt au sein de la même couche analytique gouvernée que notre équipe data maintient. Il dispose d’un environnement Python pour la visualisation des données et l’inférence statistique. Et pour vraiment tirer parti de ces outils, il s’appuie sur une bibliothèque de compétences et une couche de contexte qui lui indique comment tout s’articule.
On l’a conçu pour s’intégrer là où les gens travaillent déjà : Slack. Les membres de l’équipe posent une question en anglais courant en tapant simplement @monty dans notre canal #ask-monty, et la réponse arrive dans le fil en une ou deux minutes.
Les principes fondamentaux qui nous guident
Avant de construire quoi que ce soit, nous avons défini un socle de principes pour monty :
- L’agent doit raisonner, analyser et répondre comme un membre de confiance de l’équipe data, pour que chaque personne ait l’impression de parler directement à quelqu’un de notre équipe.
- L’agent doit savoir distinguer les questions auxquelles il doit tenter de répondre de celles auxquelles il ne doit pas répondre. S’il ne peut pas répondre à une question, il doit la faire remonter.
- L’agent ne doit utiliser que les données que l’équipe a correctement modélisées, validées et documentées.
- L’agent doit développer ses connaissances au même rythme que l’équipe data : à mesure que celle-ci crée de nouveaux modèles de données et développe de nouvelles compétences, l’agent doit automatiquement en hériter.
Nous avons commencé à travailler en nous appuyant sur ces principes.
Comment nous avons créé monty
Dans les grandes lignes, nous voulions que monty raisonne, analyse et réponde comme un membre de confiance de l’équipe data. Un LLM permet à un agent de raisonner, mais pour qu’il fonctionne comme un membre de l’équipe data, il ne suffit pas de lui donner une intelligence brute : il faut lui fournir des modèles de données validés, des compétences réutilisables et une couche de contexte. C’était le défi le plus difficile et, au final, le travail qui a fait passer monty d’un bot plutôt utile à un résolveur de problèmes indispensable. Voici les ingrédients que toutes les équipes peuvent utiliser pour créer leur propre monty.
Ingrédient 1 : une couche de modélisation des données impeccable
Pour qu’un agent d’analyse fonctionne de manière fiable, il lui faut une couche de modélisation des données irréprochable. Sans données propres et modélisées, le LLM doit démêler une mer de tables brutes à chaque question. Une bonne couche de modélisation des données, c’est ce qui fait la différence entre une ou deux étapes pour obtenir une réponse et 100, entre quelques clauses JOIN et WHERE avec presque aucune supposition et des centaines de CTE qui en regorgent.
Comme un LLM fonctionne de manière probabiliste, moins tu lui donnes de chemins possibles, moins il risque de répondre à côté. Des modèles de données propres réduisent les chemins qui peuvent le mener à une mauvaise réponse, ainsi que le nombre de décisions qu’il doit prendre dès le départ.
Pour l’équipe data de Clay, une couche de modélisation des données signifie que tout ce qui sert à l’analyse passe par dbt, de manière propre et évolutive. Chaque indicateur, chaque entité, chaque table de faits et chaque table de dimensions se trouve dans dbt. Même les données qui alimentent nos tableaux de bord proviennent essentiellement de simples instructions « select all » issues des modèles dbt. Aucune logique métier fondamentale ne se trouve en dehors de la couche de modélisation dbt.
Cette base permettait à monty de briller. Cela signifiait que la couche de contexte, dont nous parlerons ensuite, consistait simplement à apprendre à monty ce qu’il fallait savoir sur ces modèles.
Ingrédient 2 : le code comme couche de contexte
Chez Clay, l’équipe data part du code. Nos modèles dbt, notre implémentation de Dagster, les compétences de nos agents, nos tableaux de bord Streamlit, nos analyses dans des notebooks et notre documentation cohabitent dans une base de code monolithique à laquelle tout le monde est censé contribuer.
Ça signifie que notre base de code est incroyablement riche en contexte, ce qui nous a amenés à construire notre couche de contexte autour d’elle. Au début de chaque session, monty copie notre base de code dans son système de fichiers. Cette approche présente deux avantages clés :
- Nous ne maintenons pas de couche de contexte distincte de notre base de code. Faire évoluer la base de code, c’est faire évoluer la couche de contexte. Chaque fois qu’une PR est envoyée avec de nouveaux modèles dbt, de la documentation ou des compétences, de nouveaux éléments de contexte sont automatiquement disponibles pour monty.
- Le contexte peut être transféré vers n’importe quel environnement d’agent. Les environnements d’exécution diffèrent évidemment, mais toute personne qui utilise des outils comme Cursor, Codex ou Claude Code peut créer et analyser avec le même contexte de base que monty.
Ingrédient 3 : navigation guidée et hiérarchique du contexte
En copiant l’intégralité de notre base de code dans le système de fichiers de monty, nous donnons à monty une énorme quantité de contexte potentiel à exploiter. Ce contexte n’est chargé dans la fenêtre de contexte que s’il est pertinent pour la question posée.
Pour ça, on a appris à monty à parcourir le système en gardant à l’esprit le principe de divulgation progressive. Chaque dossier de notre base de code contient un fichier catalog.yml. Ce fichier sert d’index léger du contenu du dossier et indique quels fichiers peuvent contenir des informations détaillées utiles pour répondre à la question. Pour chaque question, monty consulte le catalogue, repère les informations potentiellement pertinentes, ouvre le fichier qui les contient et en fait la synthèse.
En plus de réduire les coûts, notre conception réduit aussi les erreurs. Dans son prompt système, monty apprend à traiter trois couches de contexte, en commençant par la plus déterministe et en ne se rabattant sur des couches moins déterministes qu’en cas de besoin :
- Skills : Les Skills sont des guides prédéfinis pour répondre à une question précise. Ils incluent une méthodologie définie et une description claire des modèles de données à utiliser et de la façon de les utiliser. Si monty choisit d'utiliser un Skill adapté, il y a de fortes chances qu'il réponde correctement à la question.
- Métriques : nous précalculons les métriques clés selon les dimensions et granularités temporelles courantes. Quand on lui pose une question sur une métrique, monty utilise ces agrégations préalables par défaut. Si la question porte sur une dimension que nous n’avons pas encore précalculée, il consulte le fichier de contexte de la métrique, en apprend la définition correcte, effectue une jointure avec notre table des dimensions et calcule la métrique à la volée.
- Modèles : si monty ne trouve pas la réponse dans les compétences ou les métriques, il se rabat sur des requêtes ad hoc basées sur les modèles dbt approuvés. Comme il peut lire le SQL, la documentation et la lignée de chaque modèle, il a le contexte nécessaire pour choisir les bonnes tables et les bonnes jointures.
Ingrédient 4 : un prompt système qui émule un data scientist
Le prompt système garantit que monty se comporte de façon cohérente et prévisible chaque fois qu’on lui pose une question. C’est aussi là qu’on intègre les standards d’analyse de l’équipe data au système de monty. Cela consiste à définir comment on aborde les problèmes d’analyse et comment on communique les conclusions.
Les trois fonctionnalités clés de notre prompt système sont :
- Conscience du rôle : cela façonne la compréhension que monty a de son identité et de sa mission. Avant tout, cela décrit son rôle et son périmètre en tant qu’agent d’analyse, tout en définissant ses limites.
- Si on lui demande de faire quoi que ce soit en dehors du travail d’analyse, monty indiquera à l’utilisateur que cela ne relève pas de son périmètre.
- Tout aussi important, si on lui demande de répondre à une question à laquelle il ne peut pas répondre — parce qu’elle est trop complexe ou tout simplement parce qu’il n’a pas les données — il le dira et fera remonter la question à quelqu’un de l’équipe data.
- Si on lui demande de répondre à une question à partir de données disponibles, mais absentes de nos modèles dbt, il refusera de répondre et fera remonter la demande à l’équipe data, en suggérant de créer de nouveaux modèles pour ce cas d’usage précis.
- Pensée analytique : nous fournissons à monty un cadre analytique afin qu’il aborde chaque question selon les mêmes principes fondamentaux que n’importe quel membre de l’équipe data. Par exemple, si monty comprend qu’une question suggère d’explorer un lien de causalité, il décrit ce lien à partir de données observationnelles, puis rappelle à la personne que cela indique simplement une corrélation, et non une causalité.
- Consignes de réponse : cela donne à monty des indications claires sur la forme et le ton de chaque réponse, pour offrir une expérience cohérente et familière.
- Règles d’engagement : cette section apprend à monty les trois types de messages qu’il peut envoyer à l’utilisateur final. Tout ce qui ne figure pas ci-dessous est strictement en dehors des règles d’engagement de monty :
- Une question de clarification sans laquelle il ne peut pas avancer
- Un refus ou une escalade de la question auprès de l’équipe data
- Une réponse définitive à une question
- Structure des réponses : monty apprend à commencer par une vue d’ensemble, puis à entrer dans les détails, avant d’aborder les réserves. Il ajoute ensuite un pied de page indiquant la provenance des informations, pour aider l’utilisateur final à comprendre rapidement comment il est parvenu à cette réponse et dans quelle mesure il peut lui faire confiance.
- Visualisation : monty est incité à visualiser les données par défaut quand cela aide à faire passer le message. Le cas échéant, il crée un visuel dans son environnement Python et envoie l’image sur Slack avec son texte d’accompagnement.
- Règles d’engagement : cette section apprend à monty les trois types de messages qu’il peut envoyer à l’utilisateur final. Tout ce qui ne figure pas ci-dessous est strictement en dehors des règles d’engagement de monty :
monty au travail
La meilleure façon de comprendre monty, c’est de le voir réfléchir. Ci-dessous, une vraie question de #ask-monty, avec toute la boucle agentique derrière la réponse. Clique sur la boucle agentique de monty pour voir chaque étape entre la question et la réponse.
la réception de Monty
Comme monty a accès à des modèles analytiques dans de nombreux domaines de l’entreprise, son adoption s’est faite naturellement au sein d’un large éventail d’équipes chez Clay. La plupart des gens étaient curieux de découvrir ses capacités, ont posé quelques questions et ont reçu des réponses utiles.
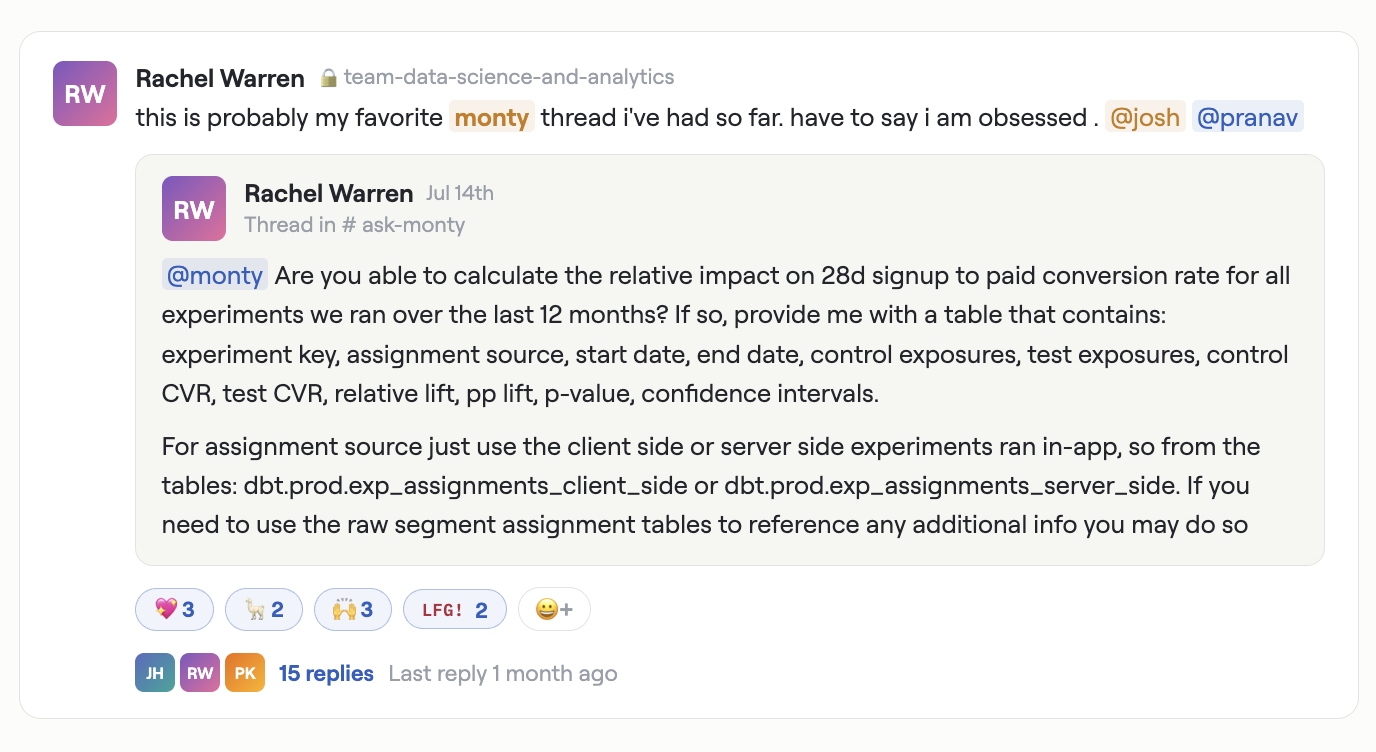
Les responsables de Compte des grandes entreprises lui posent régulièrement des questions sur la santé des Comptes et les habitudes d’utilisation du produit. Les chefs de produit consultent les indicateurs d’adoption des fonctionnalités et déboguent les entonnoirs de conversion. La finance suit les tendances du chiffre d’affaires et analyse les performances des indicateurs. La recherche utilisateur s’en sert pour segmenter les utilisateurs et comprendre leurs comportements. Le marketing de croissance s’appuie dessus pour suivre les performances des campagnes, analyser les données du site web et optimiser le parcours de conversion en libre-service. Et ils n’arrêtent pas d’en parler.
Et si, en interne, les gens n’arrêtent pas d’en parler, ils n’arrêtent pas non plus de lui parler. monty est disponible depuis un peu plus de deux mois, et 30 à 40 % de l’entreprise l’utilisent chaque semaine. 84 % des nouveaux utilisateurs reviennent poser une autre question après la première. En moyenne, les utilisateurs posent environ 2 à 3 questions par semaine. Les utilisateurs les plus assidus de monty en posent plus de 10 par semaine.
Plus étonnant encore, même nos data scientists adorent l’utiliser. Ça ne remplace pas tout à fait l’expérience d’un notebook, mais pouvoir répondre en quelques minutes à quelques questions pressantes, c’est puissant. Certains data scientists font même de l’inférence statistique légère et de la modélisation par régression avec monty.
L’avenir des équipes data
Qu’est-ce que tout ça signifie pour les équipes data ? Nous pensons que des outils comme monty leur donnent plus de moyens d’agir, au lieu de les menacer.
Dans une organisation qui utilise monty, le rôle des ingénieurs analytics devient encore plus essentiel. Quand tout le monde peut analyser des modèles de données fiables, il faut des personnes capables (a) de créer et de maintenir l’univers de données dans lequel monty peut effectuer ses requêtes et (b) de garantir l’exactitude des données, aujourd’hui comme demain. Les ingénieurs analytics sont les mieux placés pour ça.
Les data scientists peuvent consacrer l’essentiel de leur temps aux problèmes les plus complexes qu’une entreprise doit résoudre. C’est bien plus épanouissant que de répondre régulièrement à des questions analytiques de base, et cela génère un meilleur retour sur investissement pour l’entreprise.
Enfin, cette configuration augmente la demande pour le travail de l’équipe data. Avant monty, seule une petite partie des équipes pouvait tirer parti des données. Aujourd’hui, presque tout le monde le peut. Des personnes qui ne posaient jamais de questions s’y mettent, et dès qu’elles en voient l’intérêt, leurs questions en font naître d’autres. Au fil du temps, elles passent de questions simples à des questions plus pointues, à mesure que les équipes réfléchissent plus en profondeur à leur domaine et au rôle que les données peuvent y jouer.
Quand davantage de personnes qui ne sont pas spécialistes de la data commencent à utiliser les données, la culture d’une organisation évolue. Le rêve et la promesse des équipes data ont alors plus de chances de devenir réalité : une organisation où chaque personne s’appuie sur les données pour prendre ses décisions.