Clay est une plateforme de go-to-market : les équipes commerciales et marketing l’utilisent pour trouver des personnes et des entreprises, puis les enrichir avec des données comme leurs intitulés de poste, leur localisation et leurs expériences passées. À la base, il y a CPJ, un jeu de données structuré de plus d’un milliard d’enregistrements d’entreprises, de personnes et de postes, chacun étant un document imbriqué pouvant compter jusqu’à environ 165 champs.
Pendant longtemps, on ne pouvait pas répondre à des questions simples sur nos propres données :
- Quel pourcentage de personnes ont un intitulé de poste ?
- À quelle fréquence une fiche est-elle mise à jour ?
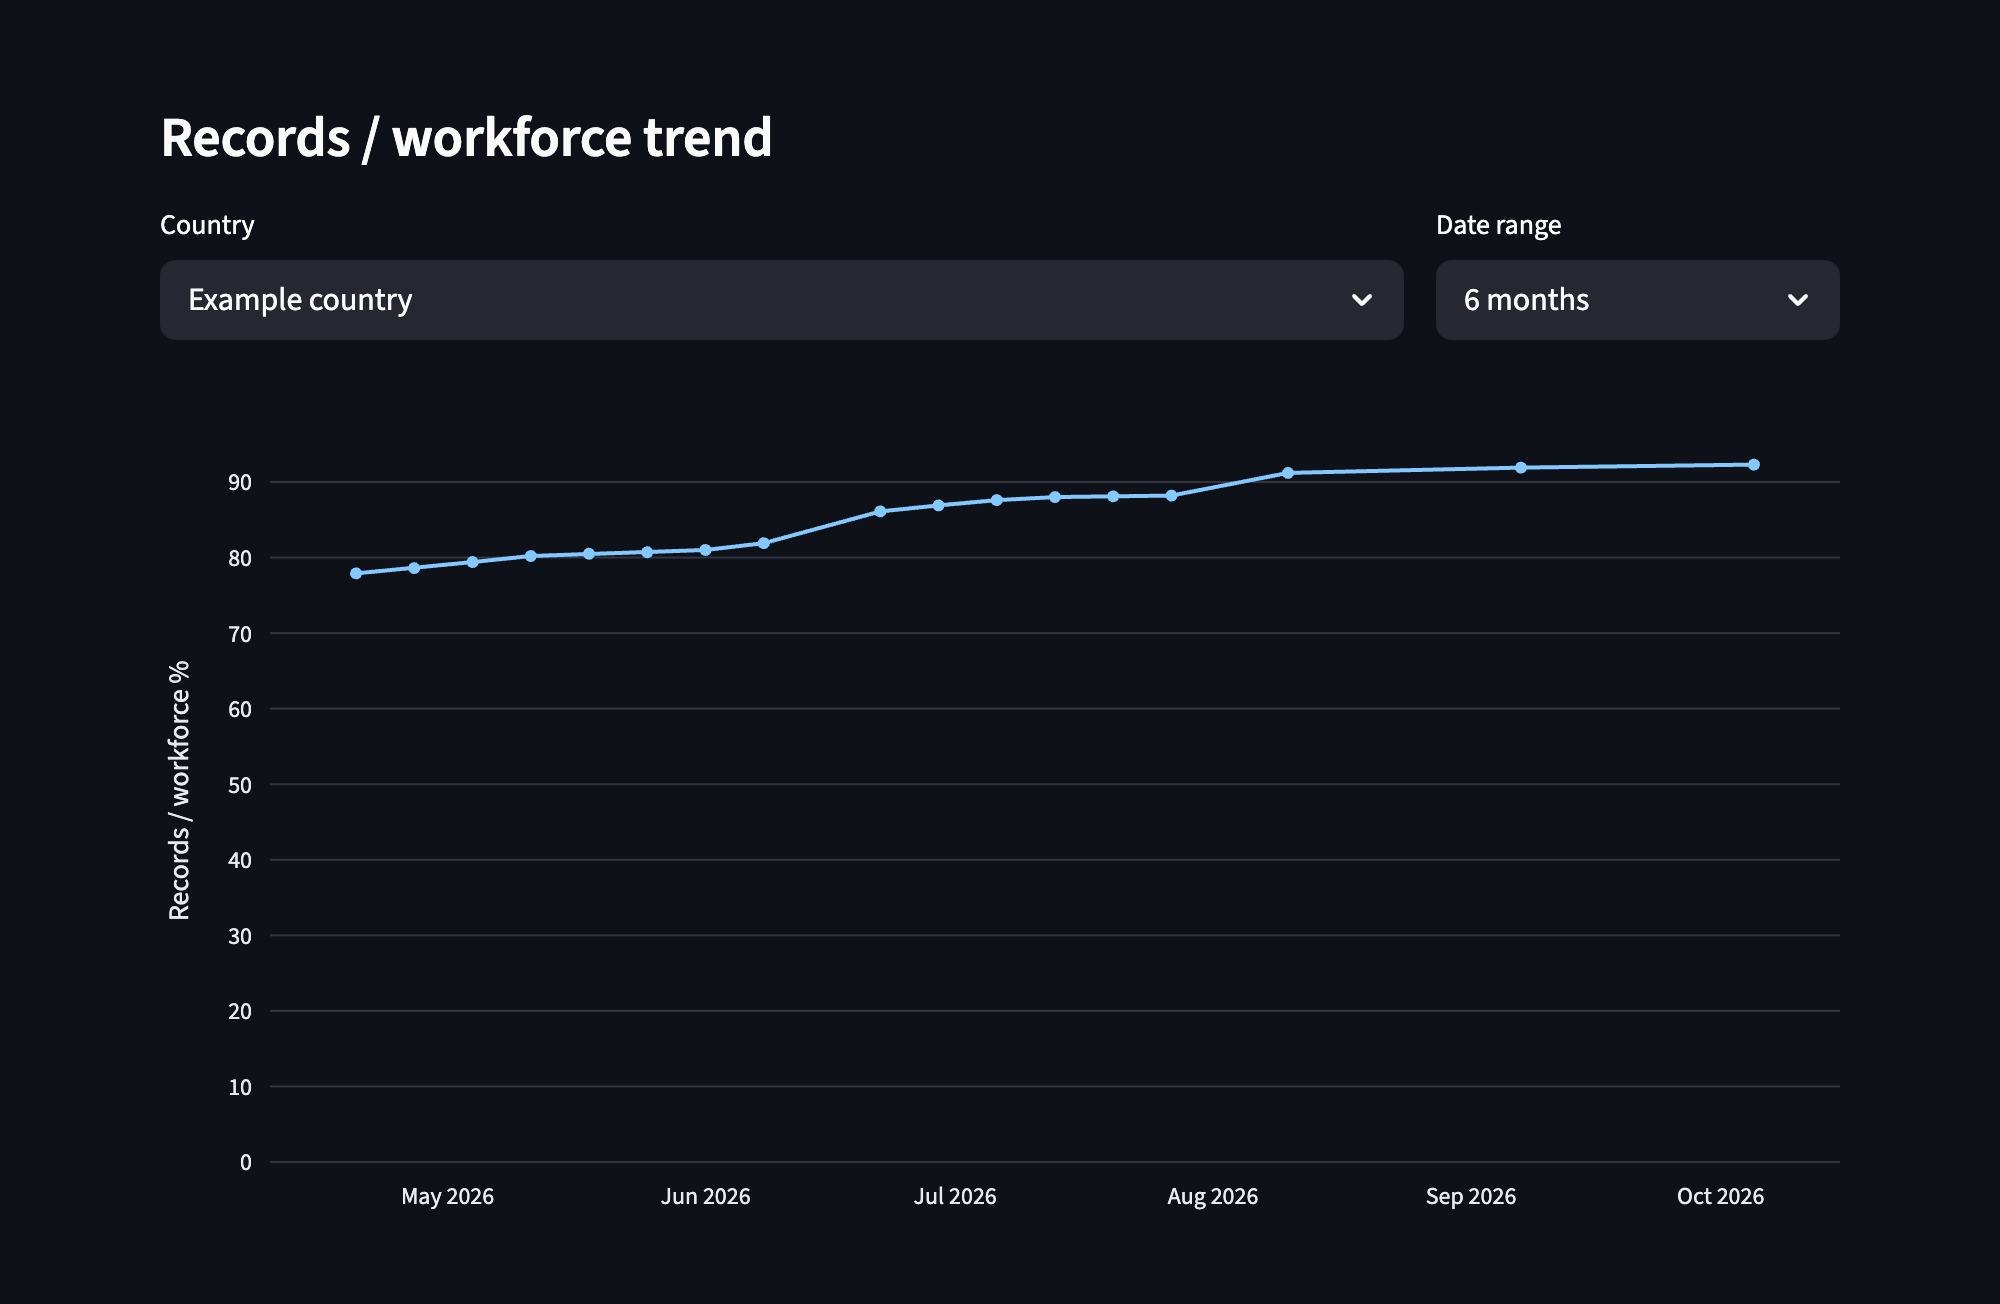
- Notre couverture s’améliore-t-elle au fil du temps ?
- Quelles sont nos fiches les plus populaires ?
Sans ces informations, il était très difficile de savoir quand les régressions des données avaient commencé et quelle était leur ampleur. On finissait souvent par exécuter des requêtes sur mesure sur des instantanés de bases de données restaurés.
CPJ Visibility, c’est le système de qualité des données que nous avons créé pour nous faciliter la vie et nous faire gagner un nombre incalculable d’heures.
Qu’entend-on exactement par qualité des données ?
Nous définissons et mesurons la qualité de CPJ à l’aide de 5 indicateurs, répartis en deux groupes.
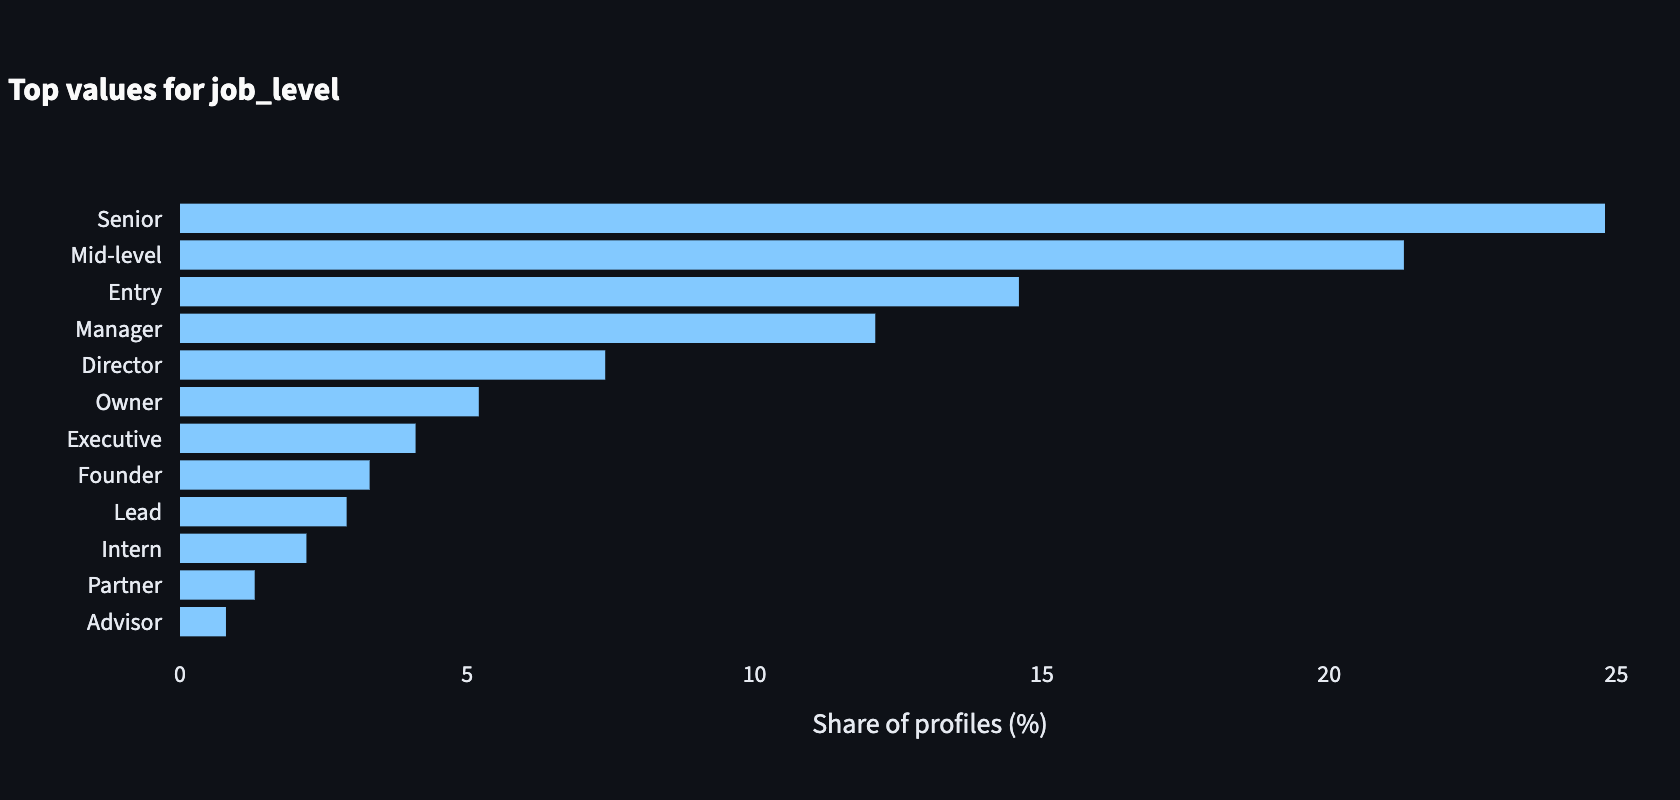
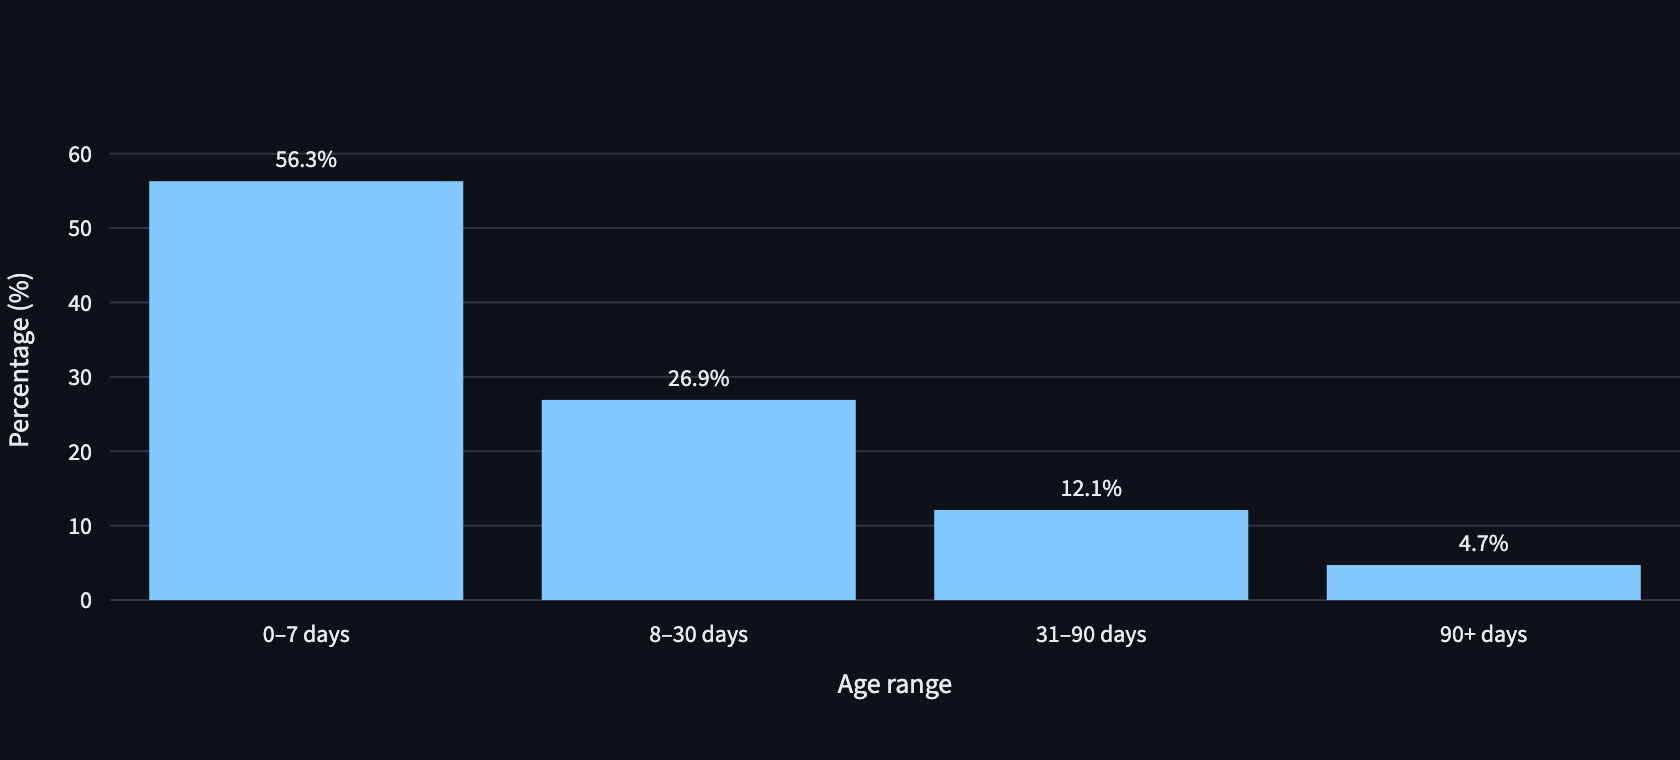
- Les indicateurs de qualité décrivent le jeu de données lui-même et ce qu’il contient. Il s’agit notamment de la couverture, de la fraîcheur, de la traçabilité et de la répartition des valeurs.
- Les métriques d’utilisation indiquent comment nos clients utilisent notre jeu de données et quels enregistrements sont les plus populaires.

Ces métriques sont calculées régulièrement afin d’établir une valeur de référence pour la qualité des données et de détecter toute régression.
Deux Pipeline, une seule vision de la qualité
Le calcul des métriques se fait via deux Pipeline, un pour chaque groupe de métriques.
À la fin de chaque Pipeline, nous combinons les données pour répondre à des questions multidimensionnelles comme : « À quelle fréquence les données sur la formation de nos profils sont-elles mises à jour pour nos 10 % de profils les plus populaires dans la région EMEA ? »
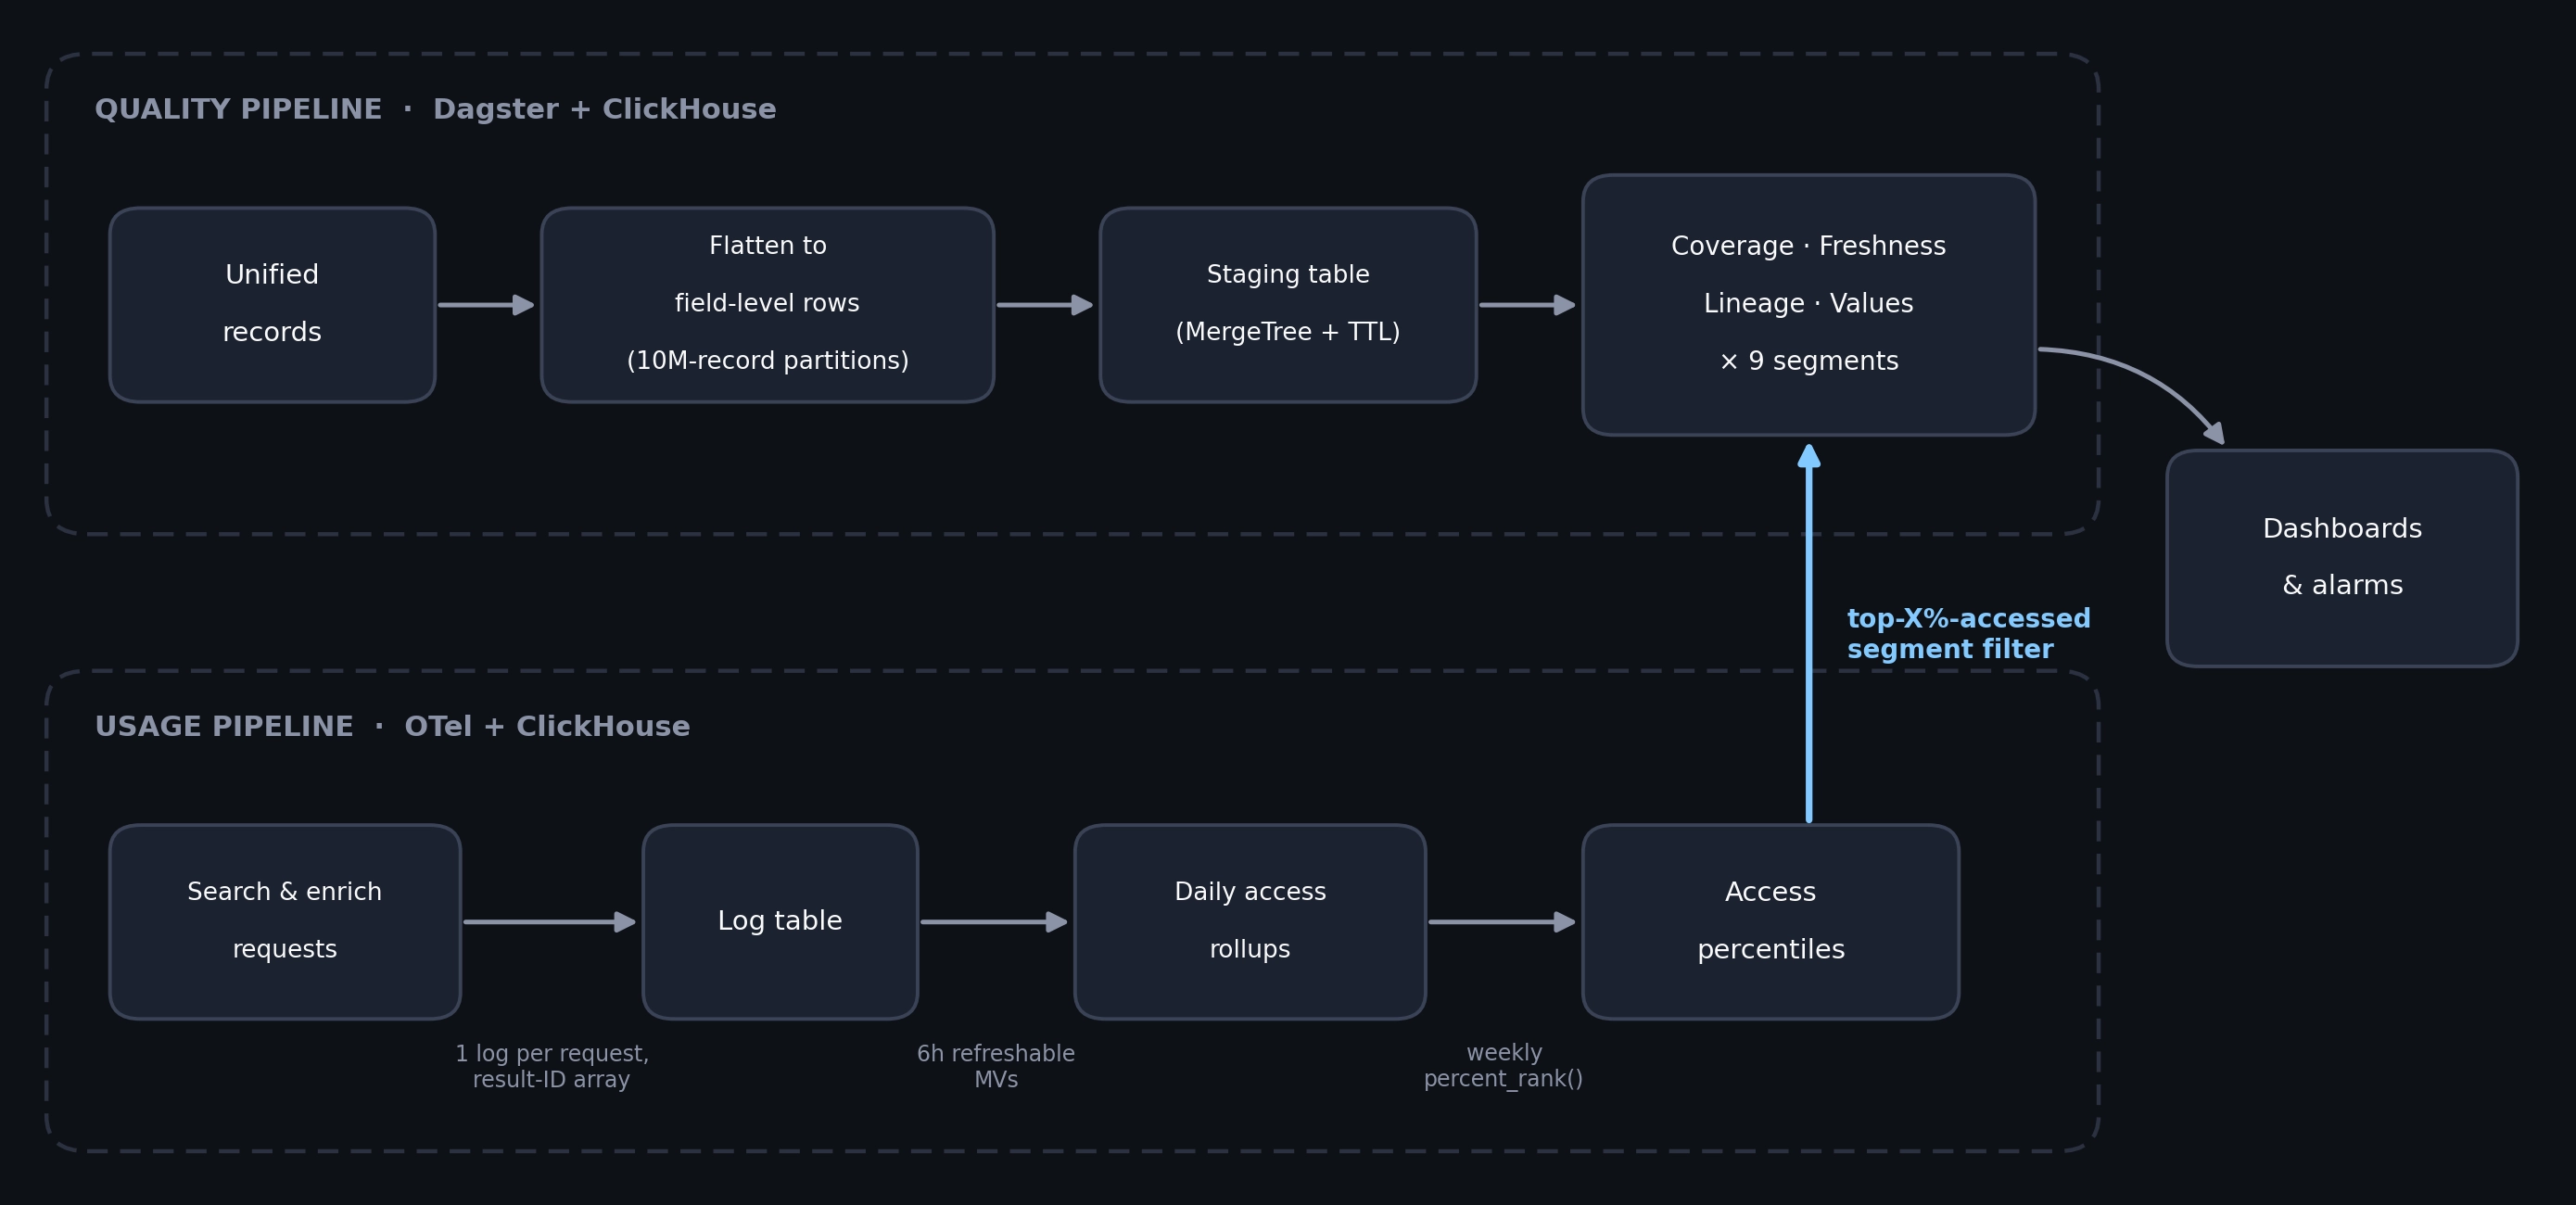
Deux choix de conception dans ce schéma :
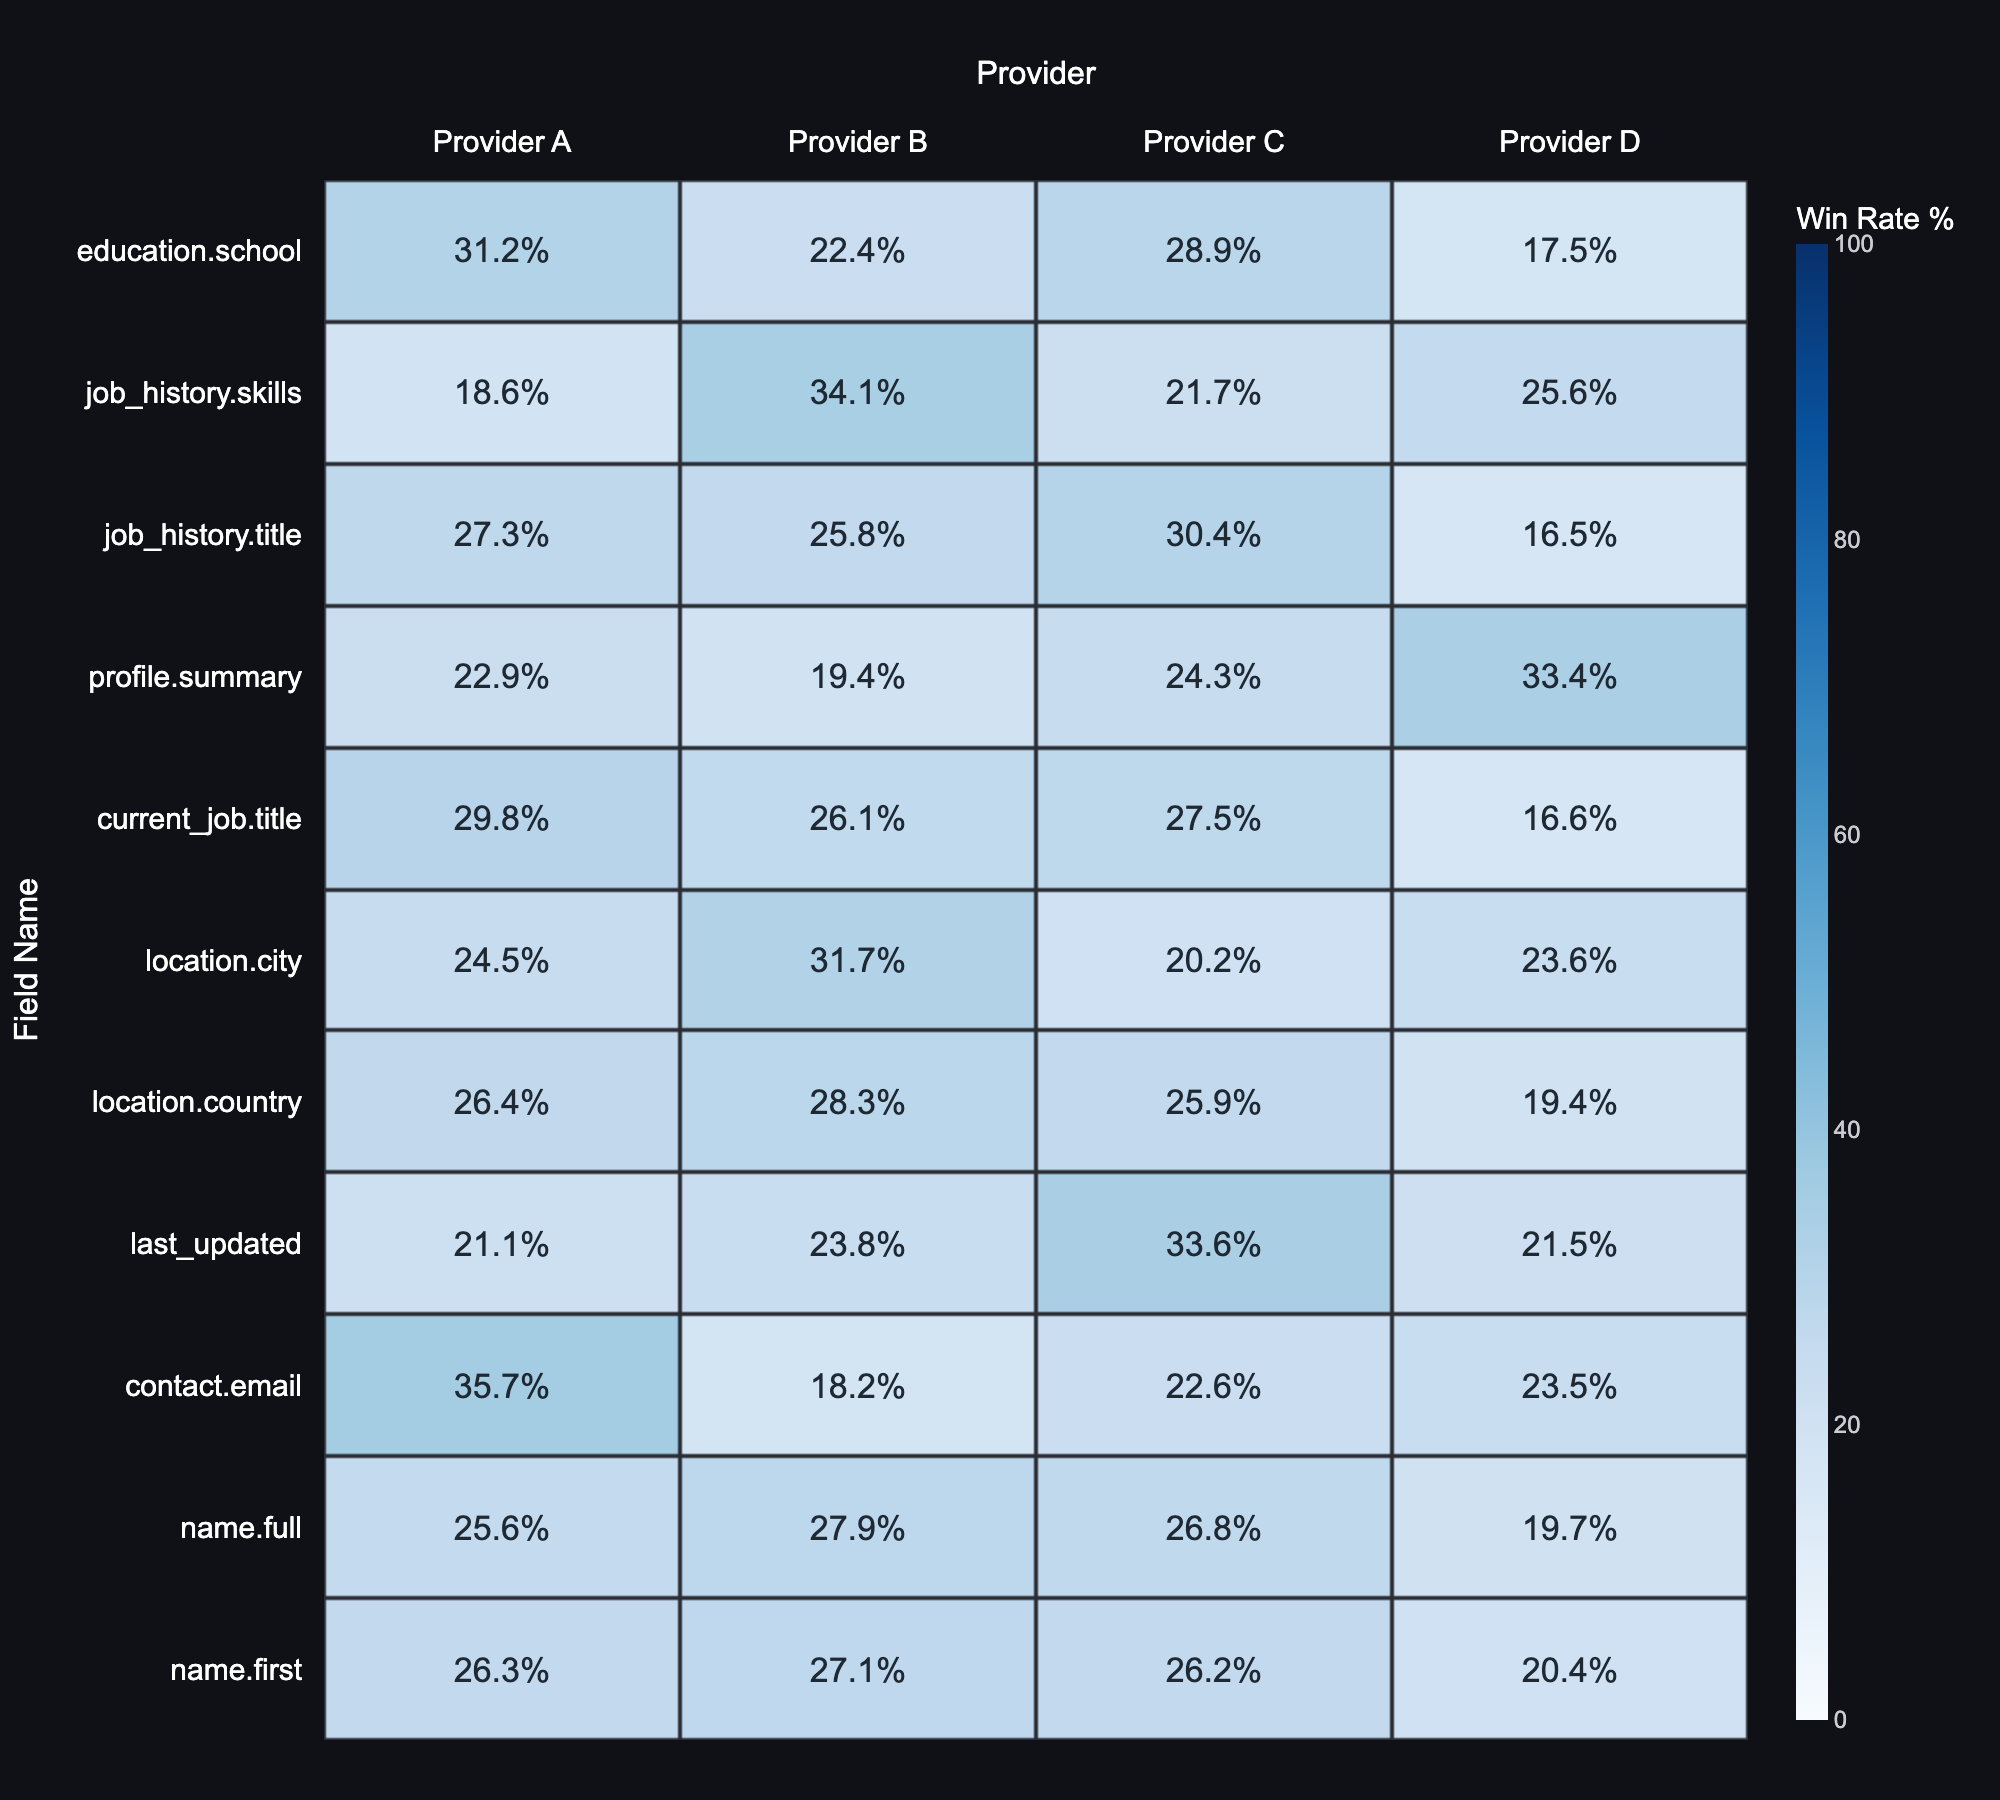
- Enregistrer la provenance au moment de la fusion : l’une des dernières étapes de notre Pipeline d’ingestion consiste à fusionner les données de plusieurs fournisseurs en une seule entité CPJ. C’est là que nous enregistrons la provenance (la fiche de quel fournisseur provient chaque champ).
- Détecter chaque jour, décrire chaque semaine : les deltas quotidiens sont assez rapides pour détecter les régressions, mais ils favorisent les enregistrements fréquemment mis à jour. Les instantanés hebdomadaires coûtent cher, mais ils reflètent le jeu de données que les clients peuvent récupérer à l’instant. On utilise l’un pour détecter les changements et l’autre pour établir une référence.
Nous utilisons ClickHouse à la fois comme moteur de calcul et comme couche de stockage. Une base de données OLAP convient bien à notre mode d’analyse hors ligne, car l’agrégation est précisément le point fort d’une base de données en colonnes. La couche de stockage de ClickHouse est aussi peu coûteuse et évolue facilement, ce qui nous permet de créer d’énormes tables intermédiaires puis de les supprimer ensuite.
L’Intégration du collecteur OpenTelemetry avec ClickHouse est également bien aboutie et nous permet de collecter des logs pour analyser les schémas de requêtes et la popularité de nos enregistrements.
Le Pipeline qualité : compter des milliards de lignes
On a une tâche d’instantané hebdomadaire qui aplatit en quelque sorte 57 milliards de lignes, avec environ 165 champs, dans une table longue de (record_id, field_name, value, provider, country, age). Ces trois dernières colonnes nous permettent de ventiler les indicateurs par pays, fournisseur et ancienneté de l’enregistrement.
Cette tâche prend environ 13 heures à s’exécuter, et notre principal défi technique consistait à la rendre robuste. Une requête qui s’exécute aussi longtemps peut échouer pour diverses raisons : rencontrer un enregistrement problématique, manquer de mémoire, subir une panne temporaire, etc.
Répartir notre travail
Notre solution a consisté à répartir nos Lignes en plusieurs partitions, qui pouvaient être traitées et relancées indépendamment. ClickHouse prend nativement en charge les partitions, ce qui a grandement simplifié les choses.
Chaque tâche de flatten lit une partition de 10 M d’identifiants, puis écrit les enregistrements dans une table de staging partitionnée selon cette même clé, avec un TTL de 14 jours pour le nettoyage. INSERT SELECT n’est pas transactionnel : une tâche interrompue laisse des Lignes partielles. Mais comme une tâche est responsable d’une seule partition, la nouvelle tentative n’a besoin d’aucune logique de déduplication :
DROP PARTITION ne touche qu’aux métadonnées, donc la récupération est instantanée. Désormais, une panne ne te fait perdre qu’un segment de 10 millions d’enregistrements, au lieu de 13 heures de travail. Et comme chaque Ligne préparée reste disponible, tu peux relancer ou modifier la phase d’agrégation sans repayer l’aplatissement !
Paie juste les 100 $
En voyant notre tâche hebdomadaire de 13 heures, on s’est naturellement demandé : est-ce qu’on pouvait optimiser quelque chose ? On a envisagé quelques options, comme calculer les stats uniquement sur le delta et les ajouter au snapshot de la semaine précédente.
Cependant, quand un recalcul complet ne coûte que 100 $, le système incrémental ingénieux ne vaut pas les frais de maintenance qu’il entraîne. Dépenser un peu plus pour tout recalculer depuis zéro chaque semaine, ça vaut la tranquillité d’esprit !
Le Pipeline d'utilisation : savoir ce que les clients utilisent vraiment
Pour comprendre comment les clients utilisent Clay et quels enregistrements ils utilisent vraiment, nous avons instrumenté nos interfaces afin qu’elles émettent des journaux OpenTelemetry indiquant quels enregistrements CPJ ont été consultés, quels filtres ont été utilisés et d’où provenaient les accès.
Ces journaux alimentent une table de journaux bruts ClickHouse, où une vue matérialisée actualisable déroule les tableaux d’ID et agrège les données en synthèses quotidiennes par enregistrement (record_id, day, source, query_volume).
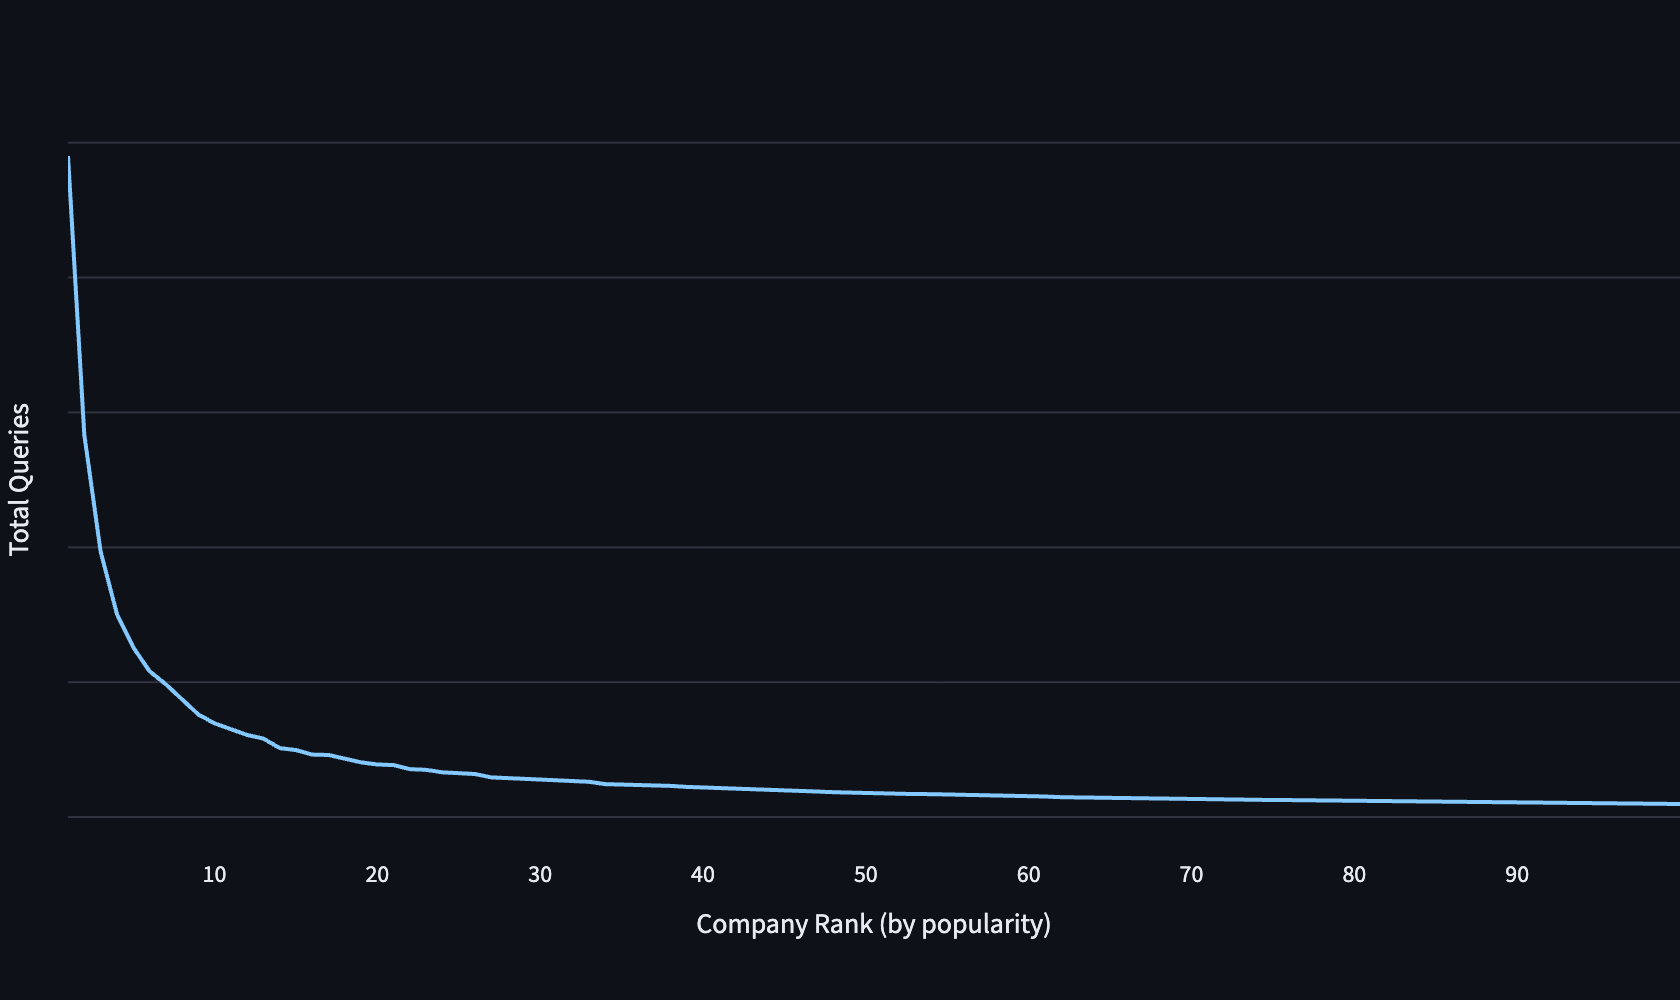
Une tâche hebdomadaire distincte traite ces agrégations pour calculer les rangs percentiles en fonction du volume de requêtes, et génère une table qui classe chaque enregistrement CPJ par popularité.
Comme nos tables d’agrégation sont devenues trop volumineuses, nos tableaux de bord internes affichent des approximations (précises) pour gagner en rapidité, calculées grâce à l’échantillonnage de Ligne dans ClickHouse. Mais l’échantillonnage direct des tables d’agrégation signifie qu’une Ligne avec query_volume=10000 a autant de chances d’être écartée qu’une Ligne avec query_volume=1. Nous avons résolu ce problème en décomposant chaque agrégation en compartiments de ≤4 requêtes dotés d’une clé d’échantillonnage hachée, afin que l’échantillonnage de Ligne reflète mieux l’échantillonnage du trafic.
Là où les deux moitiés se rejoignent
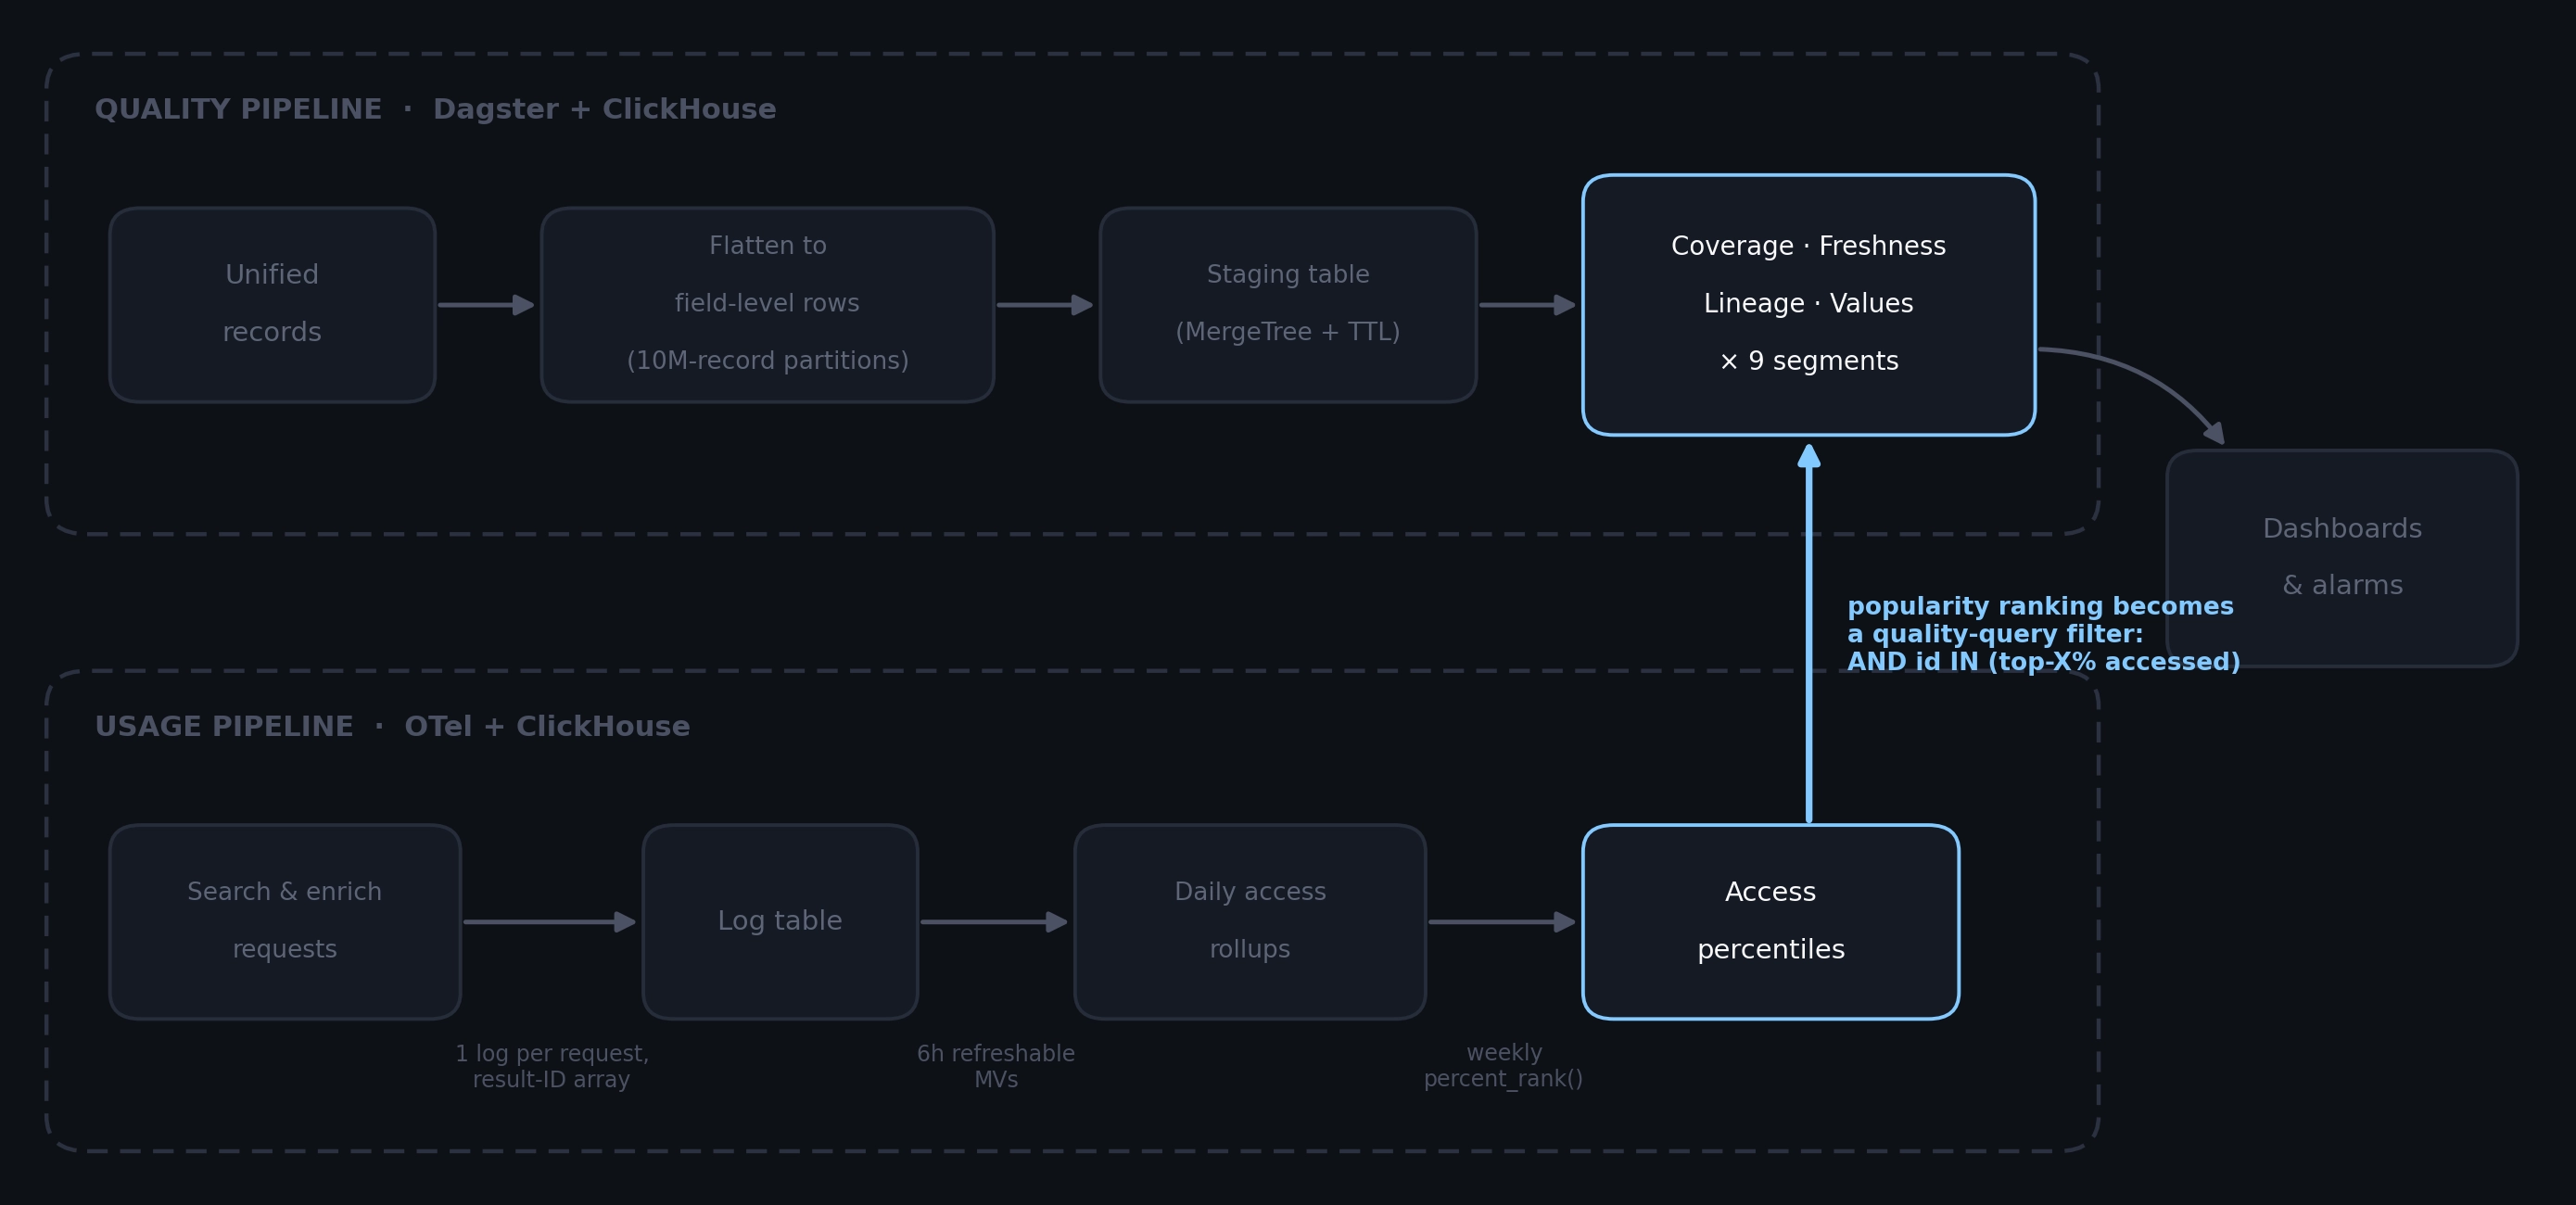
Les résultats des deux Pipelines peuvent être combinés pour répondre à des requêtes très précises sur nos données. Le tableau hebdomadaire des percentiles peut servir de prédicat de filtre pour les requêtes sur la qualité et nous aider à répondre à des questions comme : « Quelle est la répartition des valeurs de localisation pour les 5 % d’entreprises les plus populaires consultées via les Actions d’Enrichissement de Clay ? »
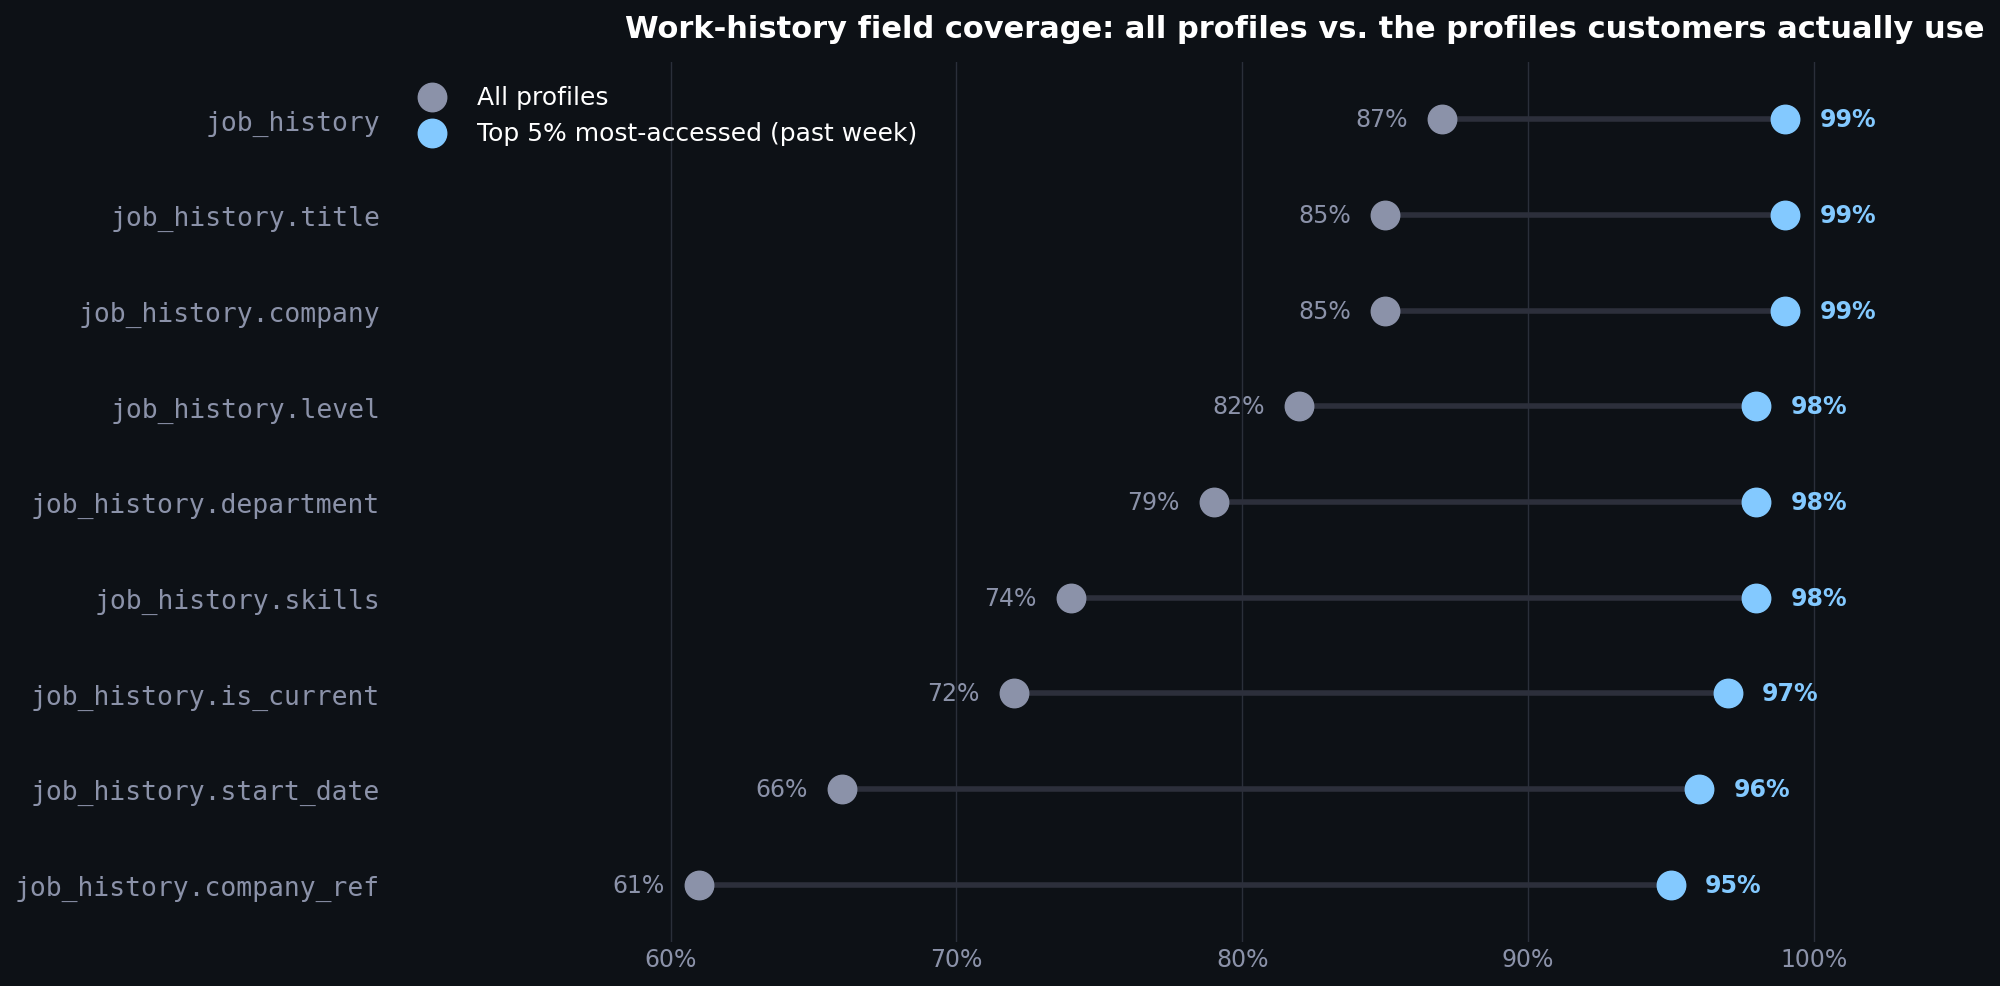
C’est là que se trouve le véritable bénéfice : dans le schéma ci-dessous, on voit que
- 69 % des profils indiquent des compétences liées à l’expérience professionnelle
- mais 99 % des profils du top 5 % les indiquent
Comme la couverture mondiale varie selon les régions, savoir quelles fiches comptent pour les clients nous permet de concentrer les améliorations de qualité là où elles comptent le plus.
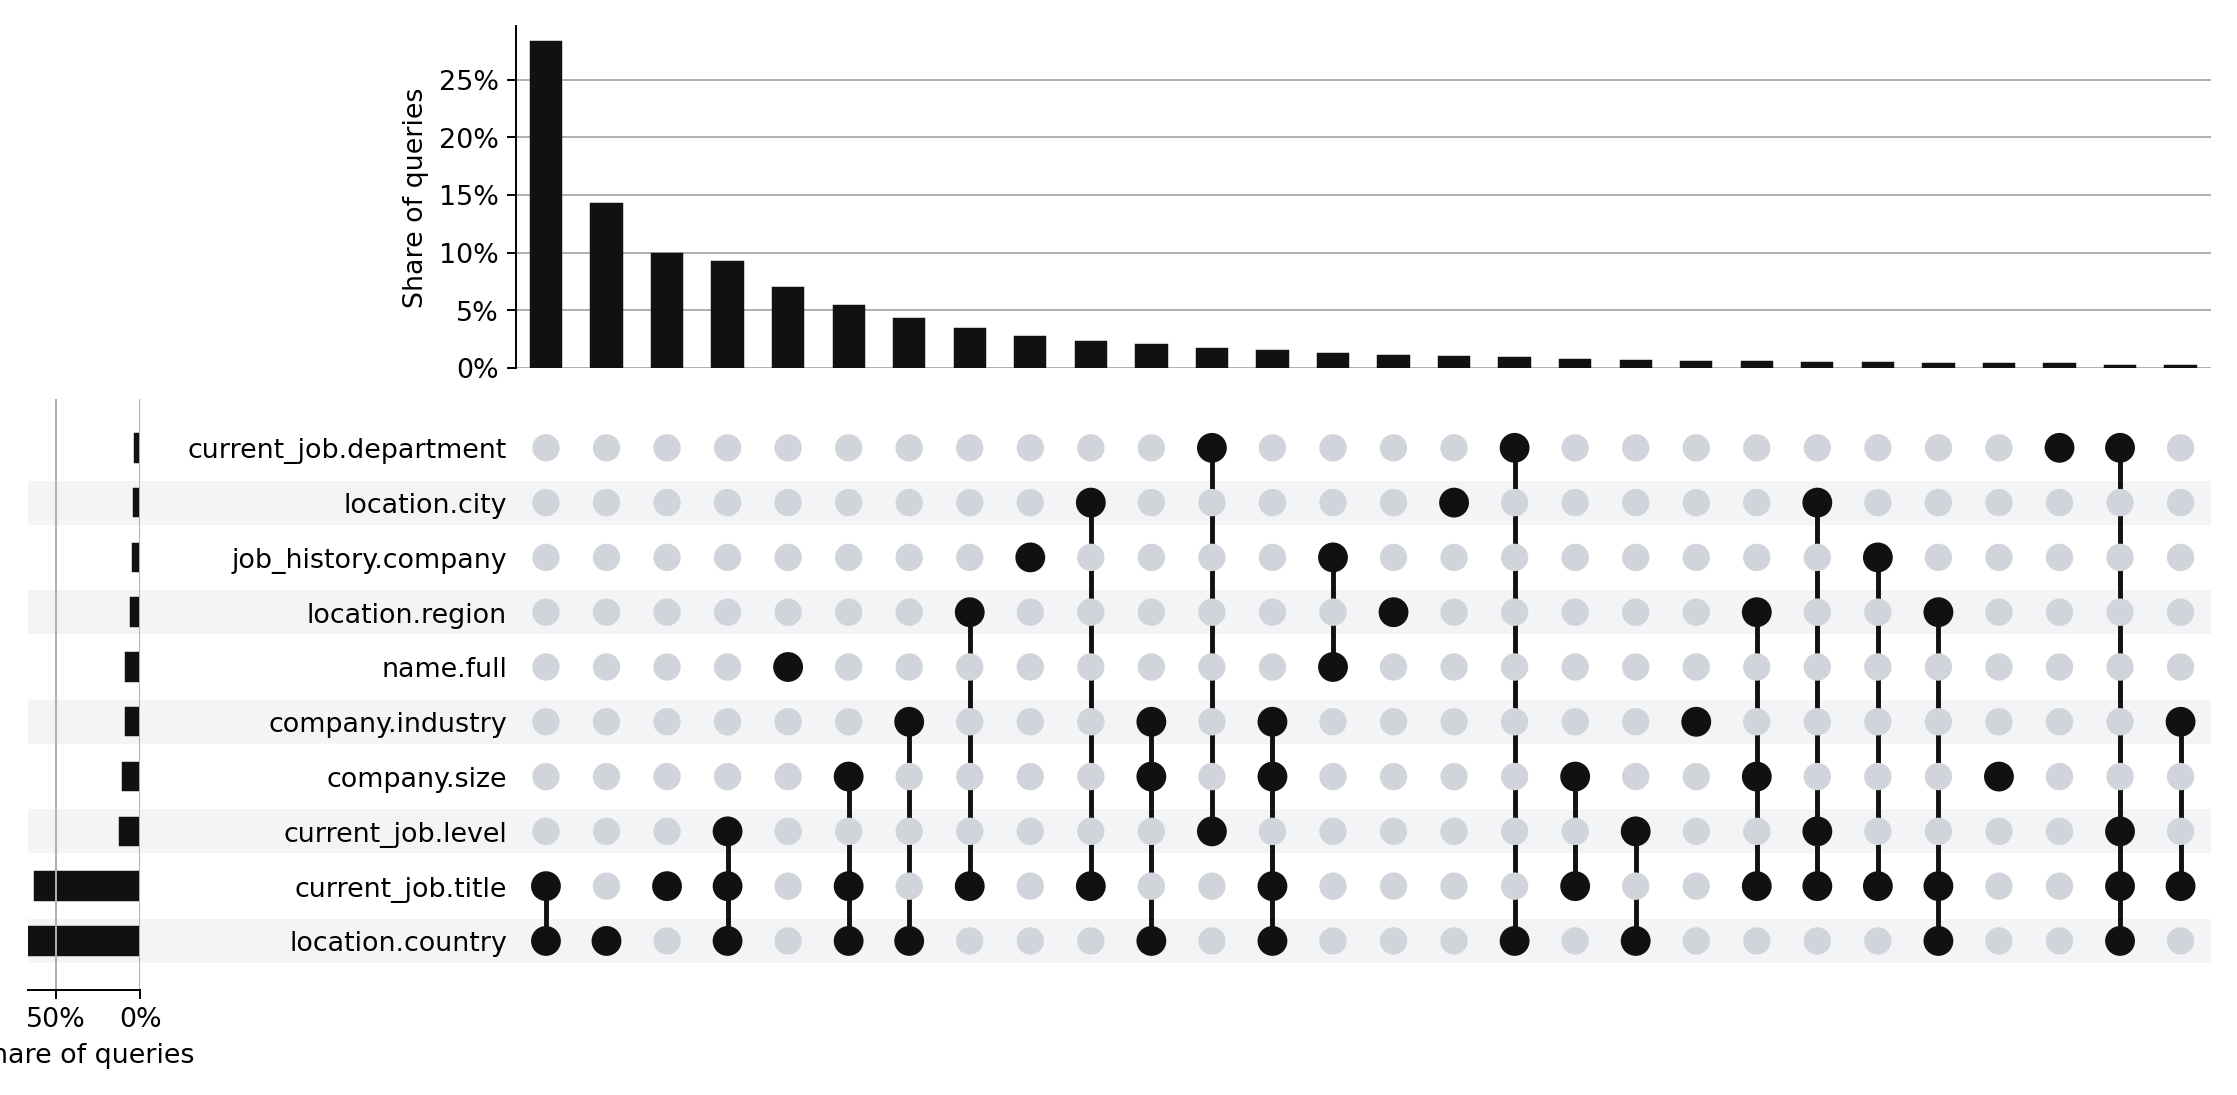
Les mêmes journaux d’utilisation révèlent aussi les champs sur lesquels les clients ont tendance à filtrer. Un processus hebdomadaire recense les champs utilisés ensemble comme filtres dans les requêtes réelles, puis représente le résultat dans un graphique UpSet. Un champ qui apparaît dans la plupart des recherches est soumis à des critères de qualité différents de ceux d’un champ sur lequel personne ne filtre.
Ce qui a changé
Tout le monde chez Clay a désormais facilement accès à la qualité des données de CPJ. L’historique de couverture, qui nécessitait des jours de restauration de snapshots l’an dernier, se charge maintenant en quelques secondes ! Nous avons aussi mis en place des alertes pour détecter rapidement les régressions de données.
Au-delà de la visibilité en interne, CPJ Visibility génère une vraie valeur commerciale. On peut dire en toute confiance à nos clients que nos données sont plus à jour que celles de nos concurrents, car on a les indicateurs pour le prouver. Les données d’utilisation nous aident à décider où investir dans de nouvelles sources de données : on donne la priorité aux pays, aux régions et aux champs pour lesquels les clients ont réellement besoin d’une meilleure couverture. Et en observant quels enregistrements sont les plus consultés, on construit un système qui améliore en continu les données qui comptent pour les clients.
Si ce genre de défis liés aux données t’intéresse, on recrute dans toute notre équipe d’ingénierie : écris-nous !