



















Imaginez que vous êtes ingénieur chez Clay. Vous ouvrez votre ordinateur après le déjeuner et recevez une notification Slack :
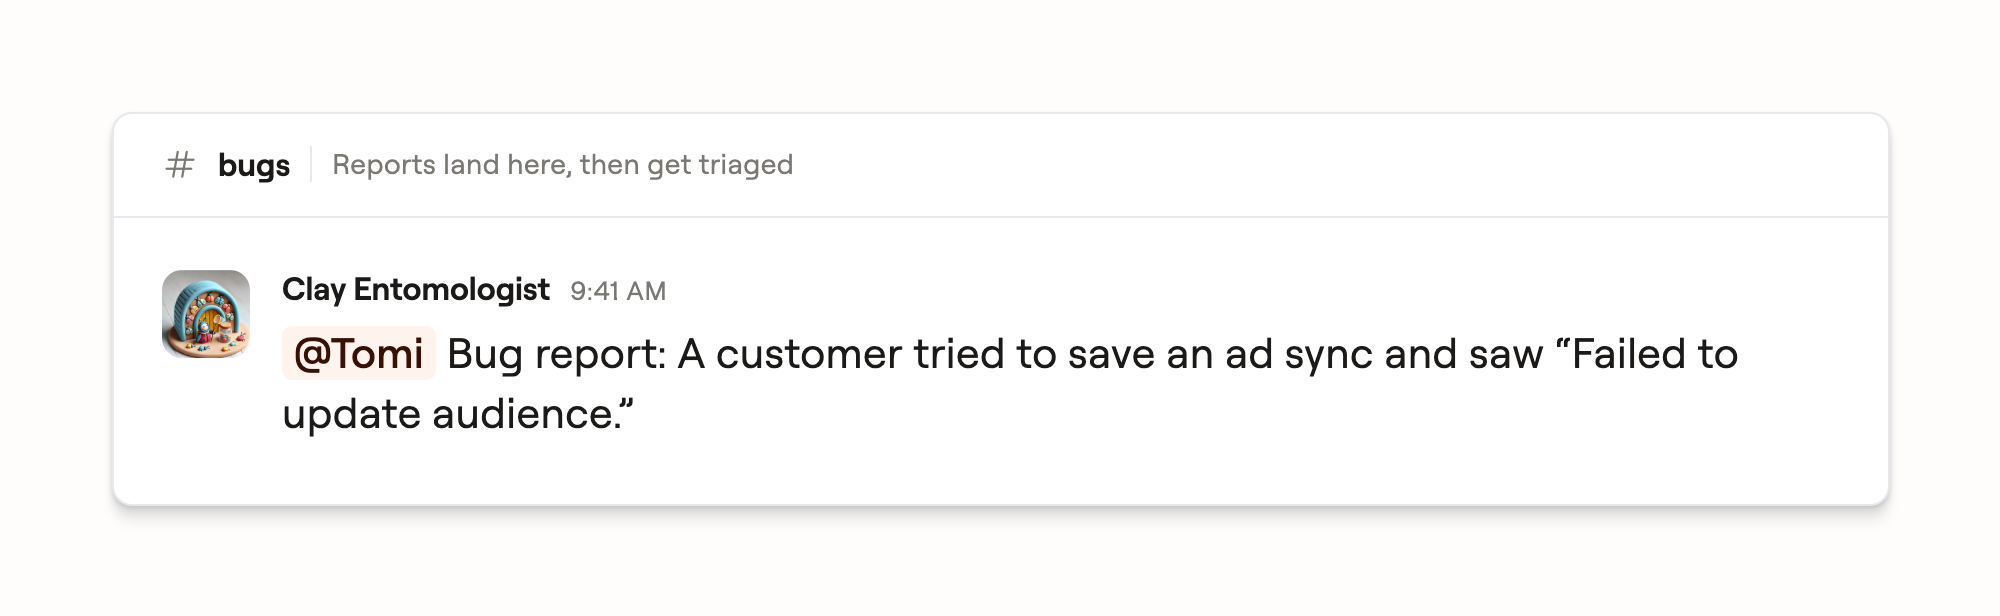
Il n’y a pas d’étapes de reproduction claires. Le rapport se limite à une brève description et à un lien vers la table concernée. Ensuite, il faut répondre à une longue série de questions : s’agit‑il d’un bug produit ? Qu’est‑ce qui a exactement échoué ? Quel chemin de code est en cause ? Qui en est responsable ? Le problème est‑il isolé ou urgent ?
Vous pouvez imaginer ce qui se passe ensuite. Avant de pouvoir corriger le bug, il faut le reconstruire : inspecter la table concernée, suivre l’**Action** de l’utilisateur dans un code vaguement familier et déterminer s’il faut modifier quelque chose.
Un de nos récents rapports de bugs a commencé ainsi. Mais, au moment où il a atteint l’ingénieur responsable, l’enquête était déjà terminée.
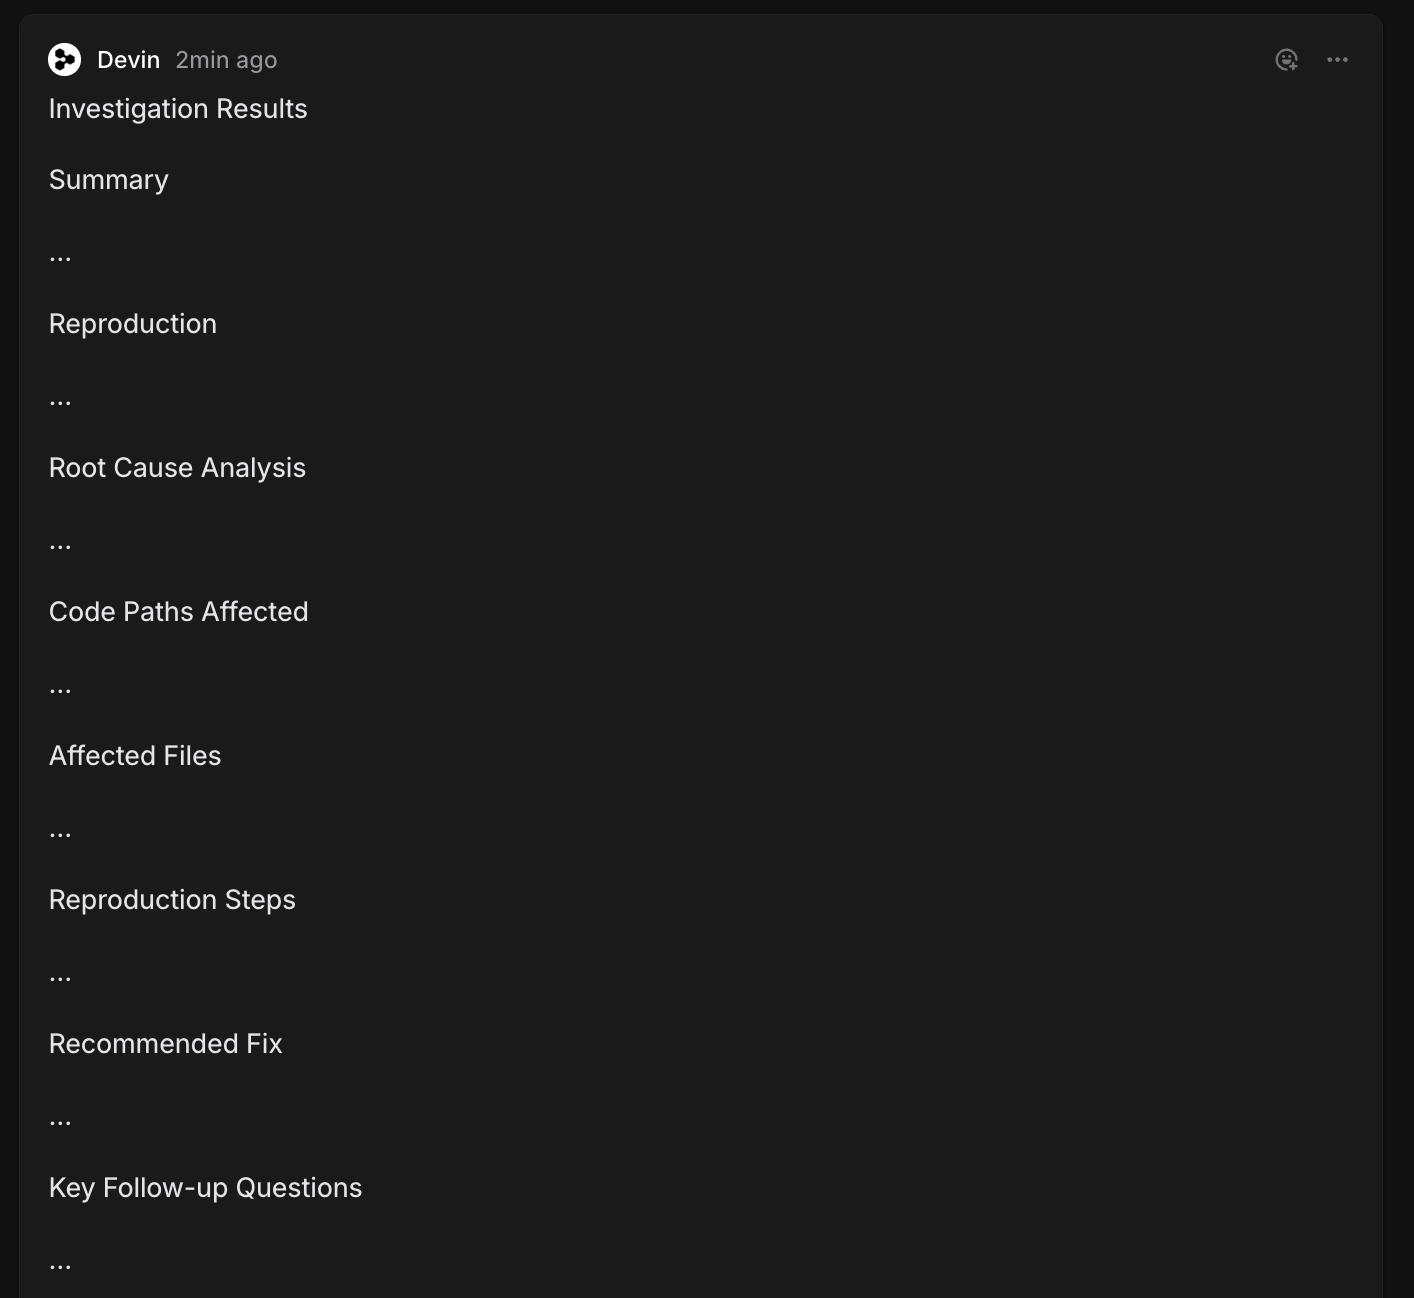
Environ 15 minutes après la soumission du rapport, notre agent de triage a isolé la défaillance à un objet inattendu qui s’est infiltré dans une cartographie de champ n’acceptant que des chaînes. Il a identifié le chemin de code concerné, reproduit le problème dans un test, proposé une correction, ouvert un petit brouillon de PR et estimé sa confiance dans l’enquête comme élevée. Il a ensuite transmis le ticket à l’équipe responsable de la surface concernée.
Plus tard, un autre client a rencontré le même problème, ce qui a clairement montré l’impact. L’ingénieur désigné a validé et fusionné le changement généré par l’agent. Le client a confirmé que la fonctionnalité fonctionnait de nouveau.
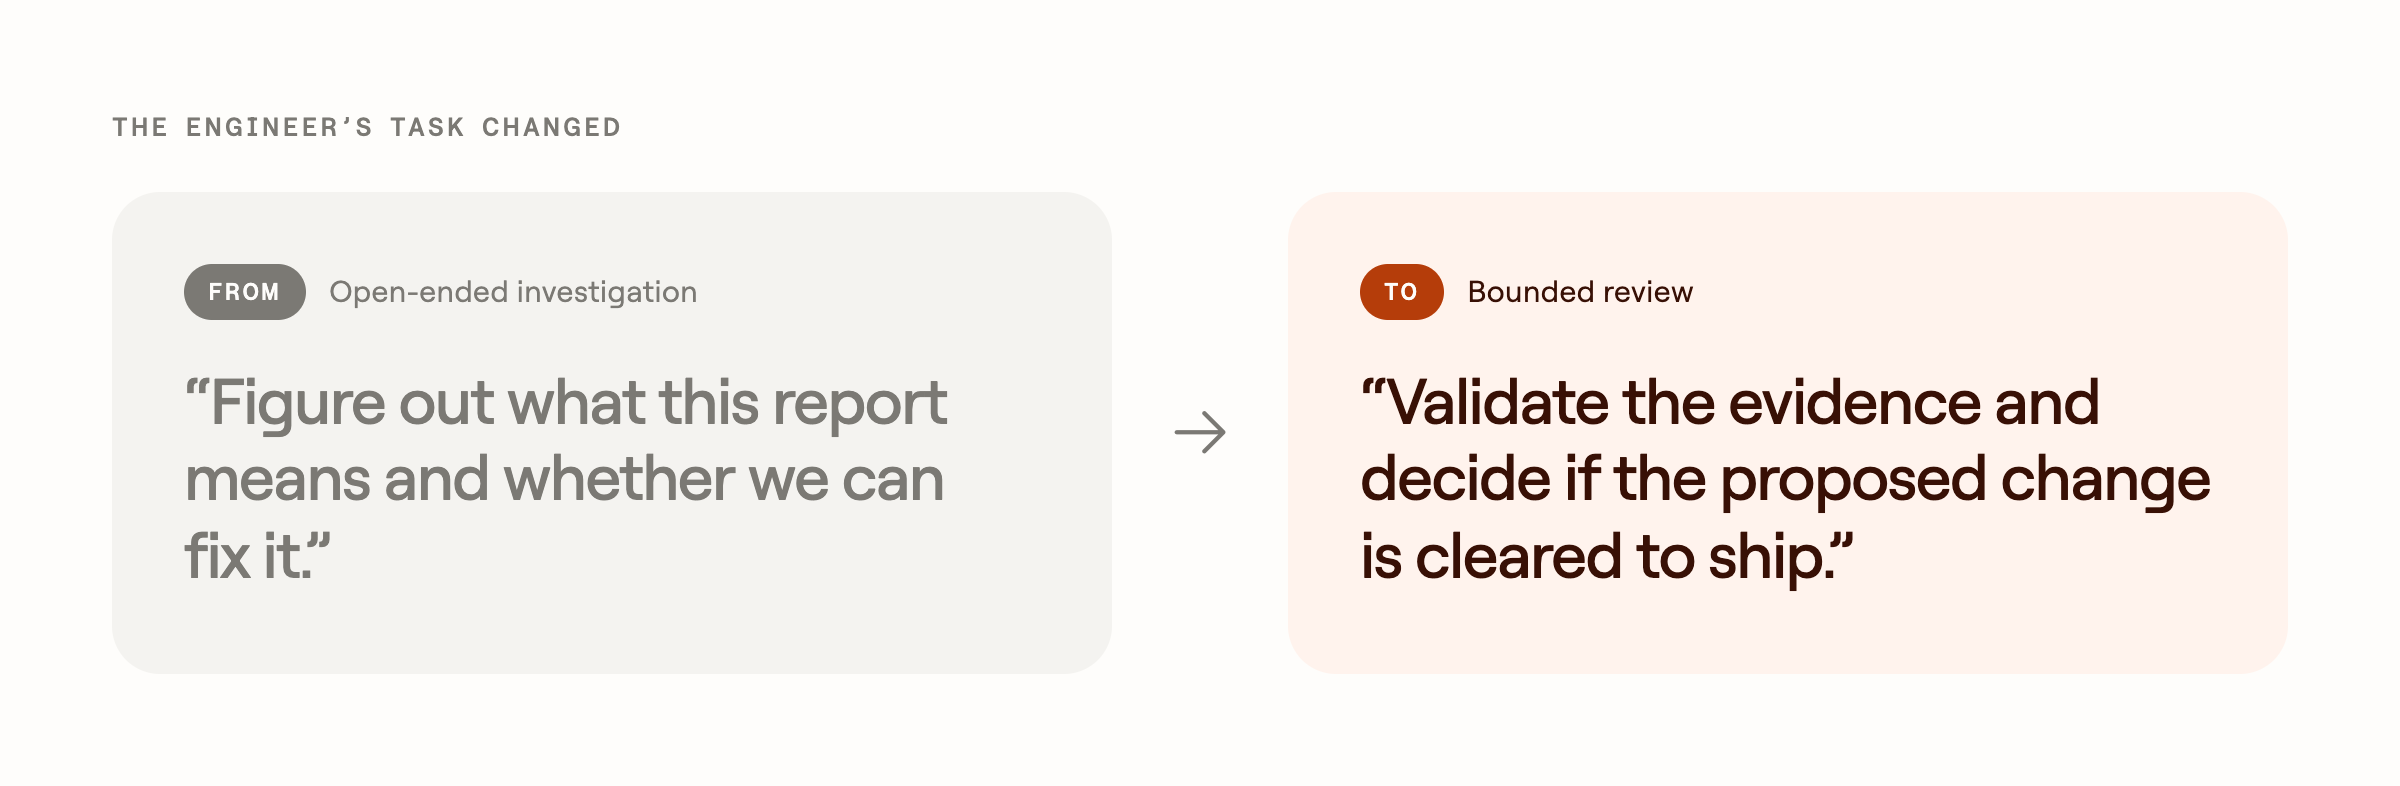
Ce changement est le cœur de notre système de triage des bugs. La rapidité compte, mais l’objectif principal est de protéger l’attention des ingénieurs. Les ingénieurs doivent passer moins de temps à rassembler le contexte, à répéter les premières investigations et à appliquer des correctifs que le système peut valider en toute sécurité. Lorsqu’un bug requiert réellement leur intervention, il doit se présenter comme une tâche claire, audible et bien délimitée.
Automatiser un flux de travail manuel
Comme beaucoup d’organisations d’ingénierie, nous gérions autrefois le triage par rotation générale. Au fur et à mesure que notre flux de travail linéaire évoluait, les rapports issus des conversations de support, de Slack et du produit arrivaient dans une file d’attente partagée.
Nous avons finalement centralisé le triage sur une seule personne à plein temps. Ce n’était pas évolutif, mais cela a rendu le processus complet visible. Cette personne a pu identifier les détails qui manquaient souvent, la télémétrie utile pour chaque type de panne, les zones où la responsabilité était floue, les rapports avec des solutions de contournement connues, et ce dont un ingénieur a besoin pour agir sans devoir recommencer l’enquête.
En plus des investigations sur les bugs, cela a exigé un travail transversal décisif. Les dirigeants d’ingénierie et de l’expérience client ont dû s’accorder sur la signification de « triage complet », le fonctionnement des escalades, la répartition des modes de défaillance entre les équipes, les priorités d’attention de l’ingénierie par rapport aux autres enjeux business, et les indicateurs qui traduisent une vraie amélioration.
La première version de l’agent disposait de directives claires et suivait le workflow du triage humain, étape par étape. Maintenant que le processus n’était plus cantonné à la tête d’une seule personne, on pouvait le mesurer, le versionner, repérer ses points faibles et améliorer chaque exécution future, au lieu de ne corriger que le ticket en cours.
Signalement de bug → Résultat clair
Aujourd’hui, la seule donnée requise est un ticket Linear. Une session d’agent continue le fait passer à la première étape technique.
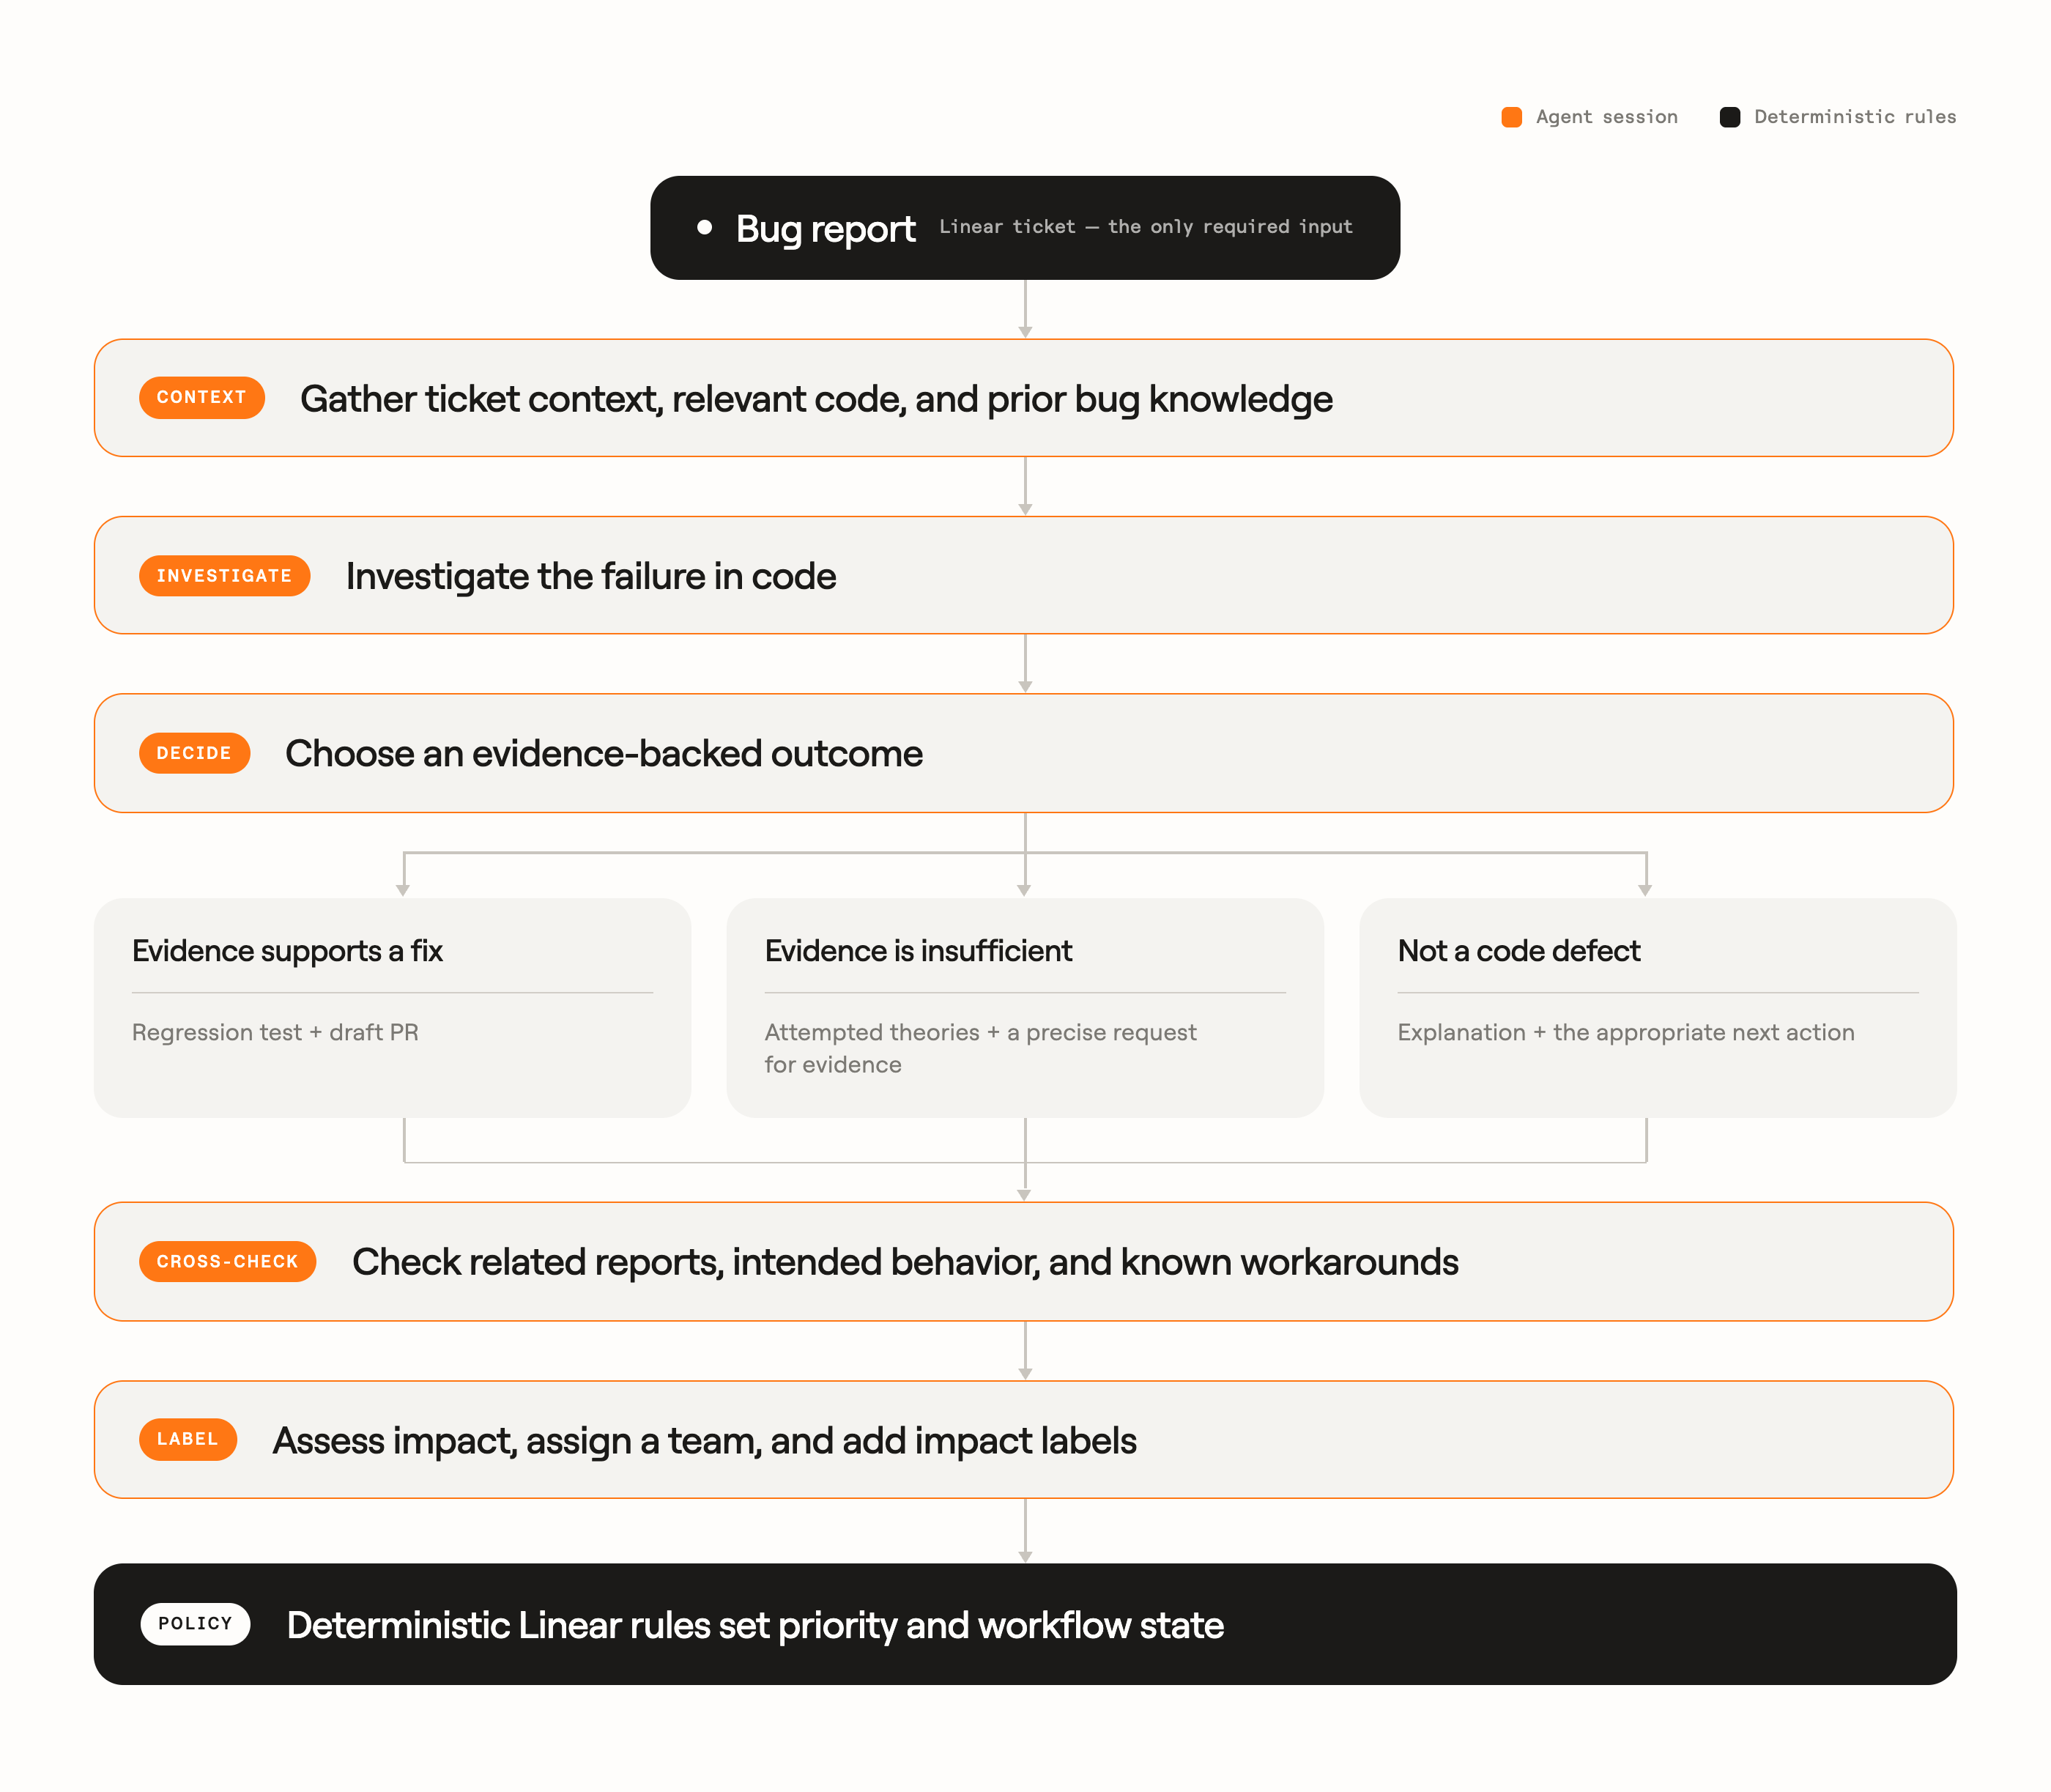
Devin identifie les problèmes, recense les zones impactées du produit et propose des PR de remédiation. Linear sert de système d’enregistrement et de couche de politique, tandis que les automatisations Clay prennent en charge certaines parties du transfert opérationnel.
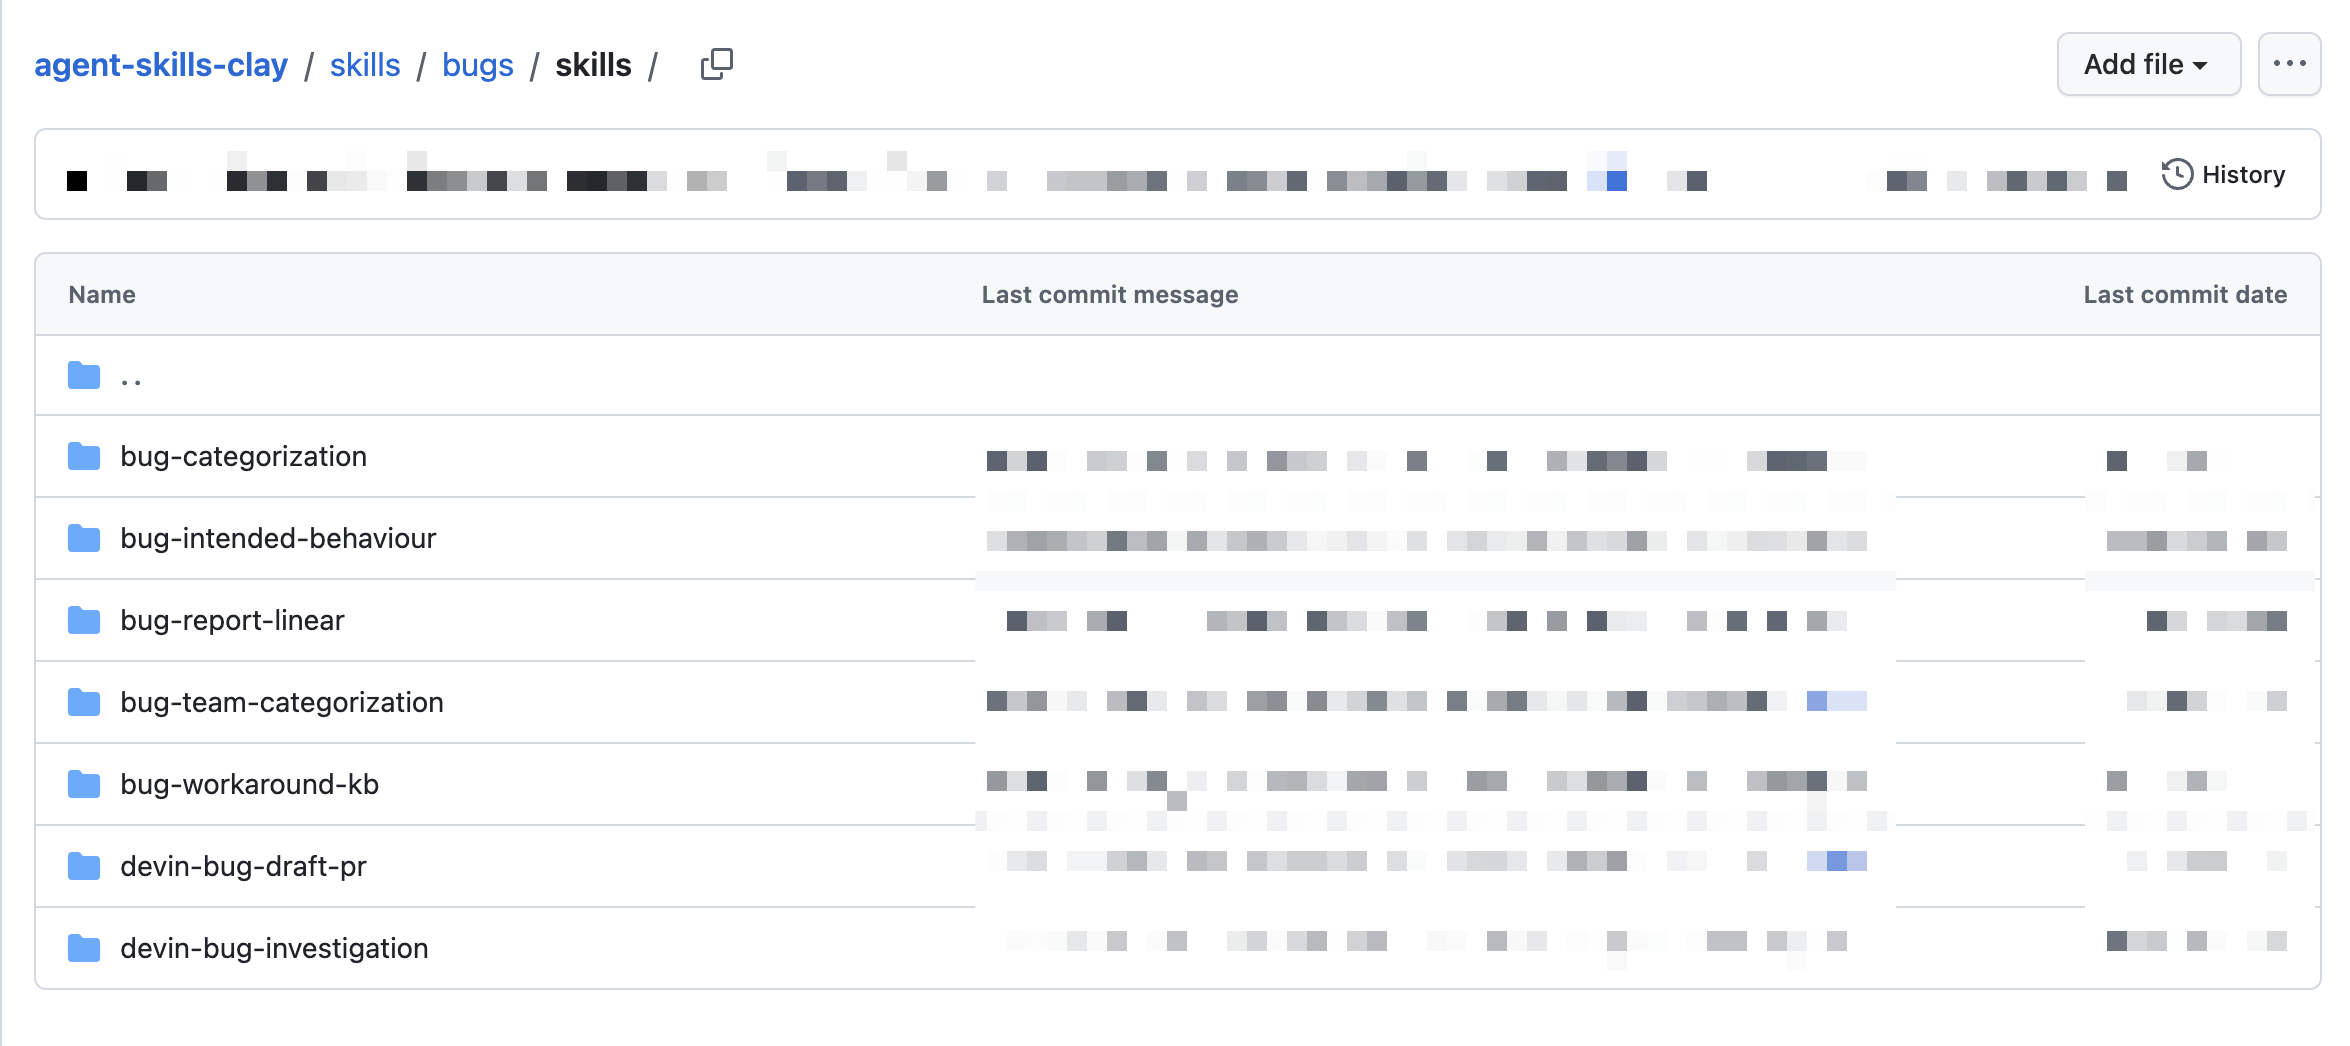
Le processus est découpé en petites compétences versionnées plutôt qu’en une longue invite. Chaque compétence a une responsabilité précise : enquête, rapport, détection de doublons, correspondance de contournement, évaluation du comportement, catégorisation ou routage. Cela crée des limites d’échec claires. Si un ticket aboutit à la mauvaise équipe, on peut se demander si l’enquête technique était erronée, si la documentation de propriété était ambiguë, ou si la compétence de routage a mal appliqué les consignes.
Comment Linear s’intègre‑t‑il à notre système ?
Les concepts de triage proviennent des recommandations de l’équipe Linear : chaque semaine, on désigne un IC, le « gardien », qui gère les bugs de son équipe. On utilise les étiquettes à bon escient et on crée des automatisations de triage qui s’appuient dessus. Comme tout notre travail d’ingénierie se fait sur Linear, on peut facilement croiser les tickets de bugs avec les retours et les tâches planifiées. Le tableau de bord de Linear nous permet de suivre les indicateurs sans solliciter l’équipe data, et nous exploitons largement leurs points de terminaison GraphQL dans notre outil interne de reporting de bugs et pour des besoins de données sur mesure.
Comment Devin s’intègre dans notre système ?
L’API de Devin a été la plus grande avancée du système fin 2025. Elle nous a permis de lancer automatiquement des sessions autonomes de Devin avec des consignes précises, afin qu’il puisse analyser les bugs et fournir des rapports Action. Devin fonctionne dans le cloud, ce qui permet à chaque utilisateur d’accéder facilement à ces sessions, de voir le travail réalisé et de poursuivre l’enquête en posant des questions de suivi.
Aujourd’hui, on utilise Devin Automations pour piloter ce processus. Notre automatisation se déclenche à chaque nouveau ticket Linear de signalement de bug et lance une session d’enquête. On profite aussi largement des instantanés machine de Devin. Chaque session démarre un environnement préconfiguré où Devin exécute notre produit en local, reproduit le bug de bout en bout et confirme que la correction proposée fonctionne.
Le tableau de bord Automations nous permet de regrouper toutes les sessions en un seul endroit, de suivre leurs dépenses, d’être alerté en cas d’échec et d’examiner chaque session.
Jugement de l’agent vs règles déterministes
Certains aspects du triage demandent un raisonnement sémantique. Les agents servent à faire le lien entre les symptômes visibles par l’utilisateur et le code, à vérifier si les anciennes solutions de contournement sont toujours valables, ou à identifier les équipes produit responsables de la panne.
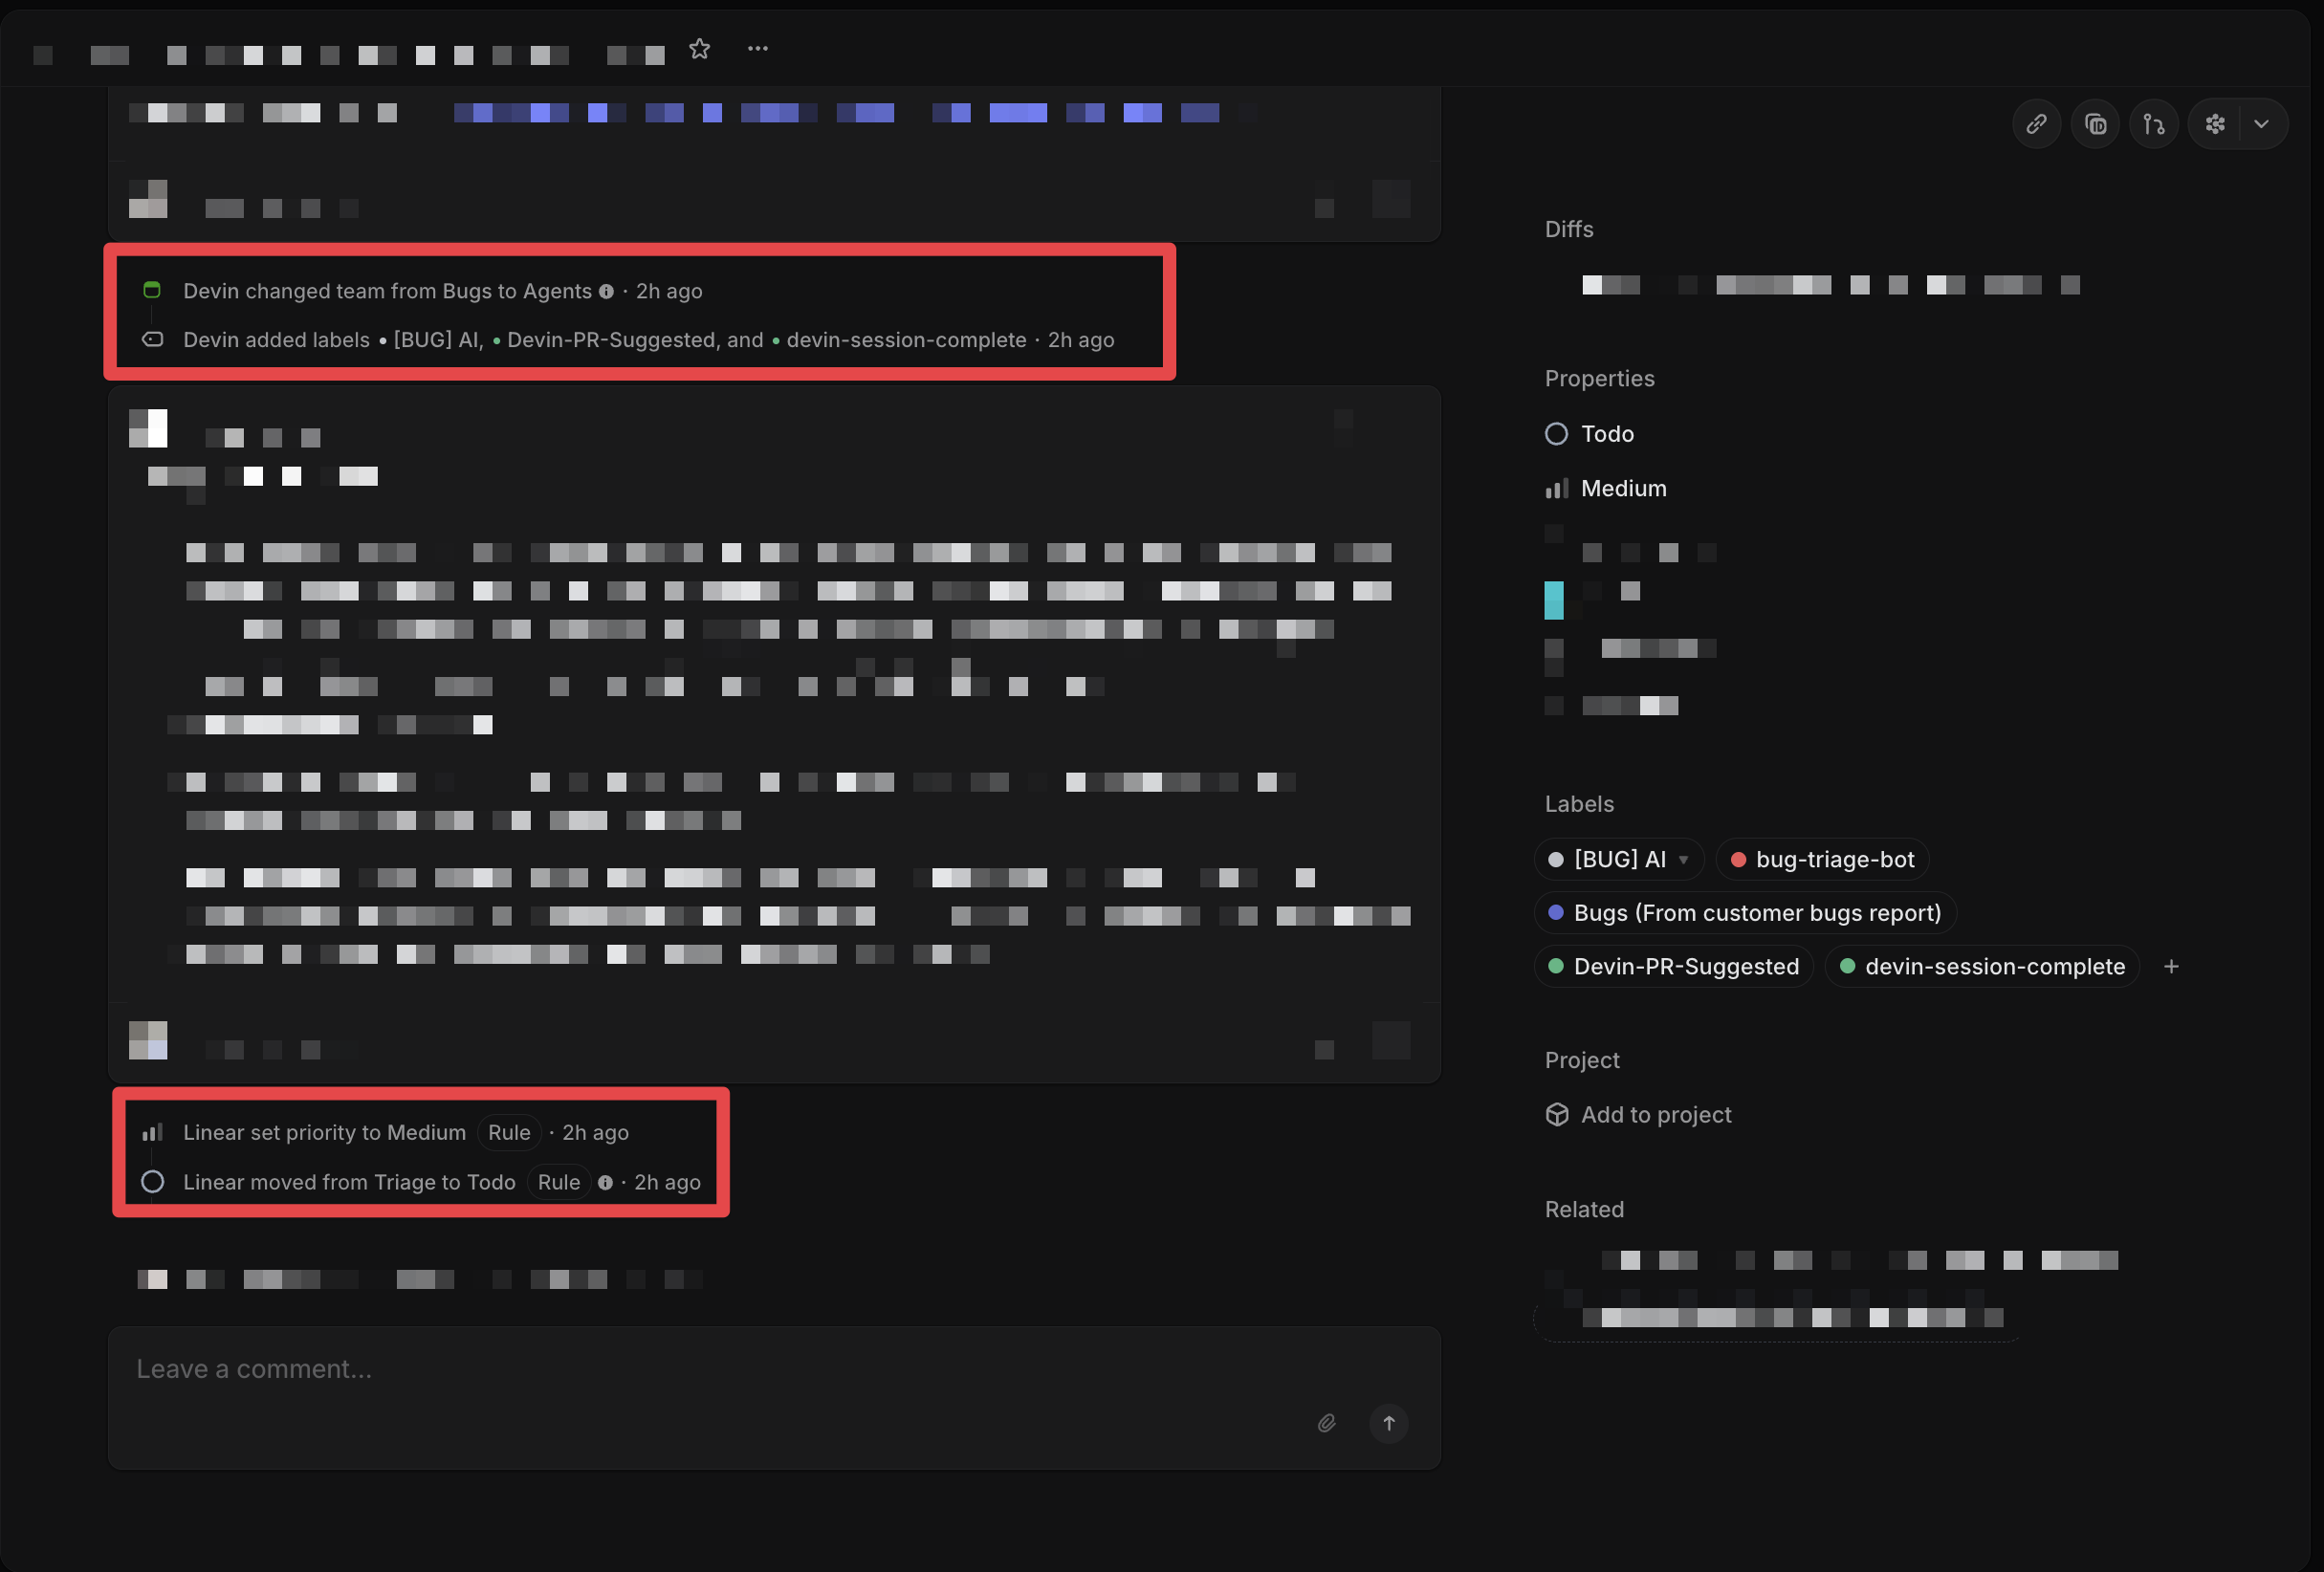
Cependant, prendre des décisions nécessite l’alignement de nombreux dirigeants, équipes et IC. Déléguer cela entièrement à l’IA peut nuire à la confiance. Bien que notre agent exploite pleinement la puissance et la flexibilité de l’IA, Action n’est prise que par des automatisations déterministes.
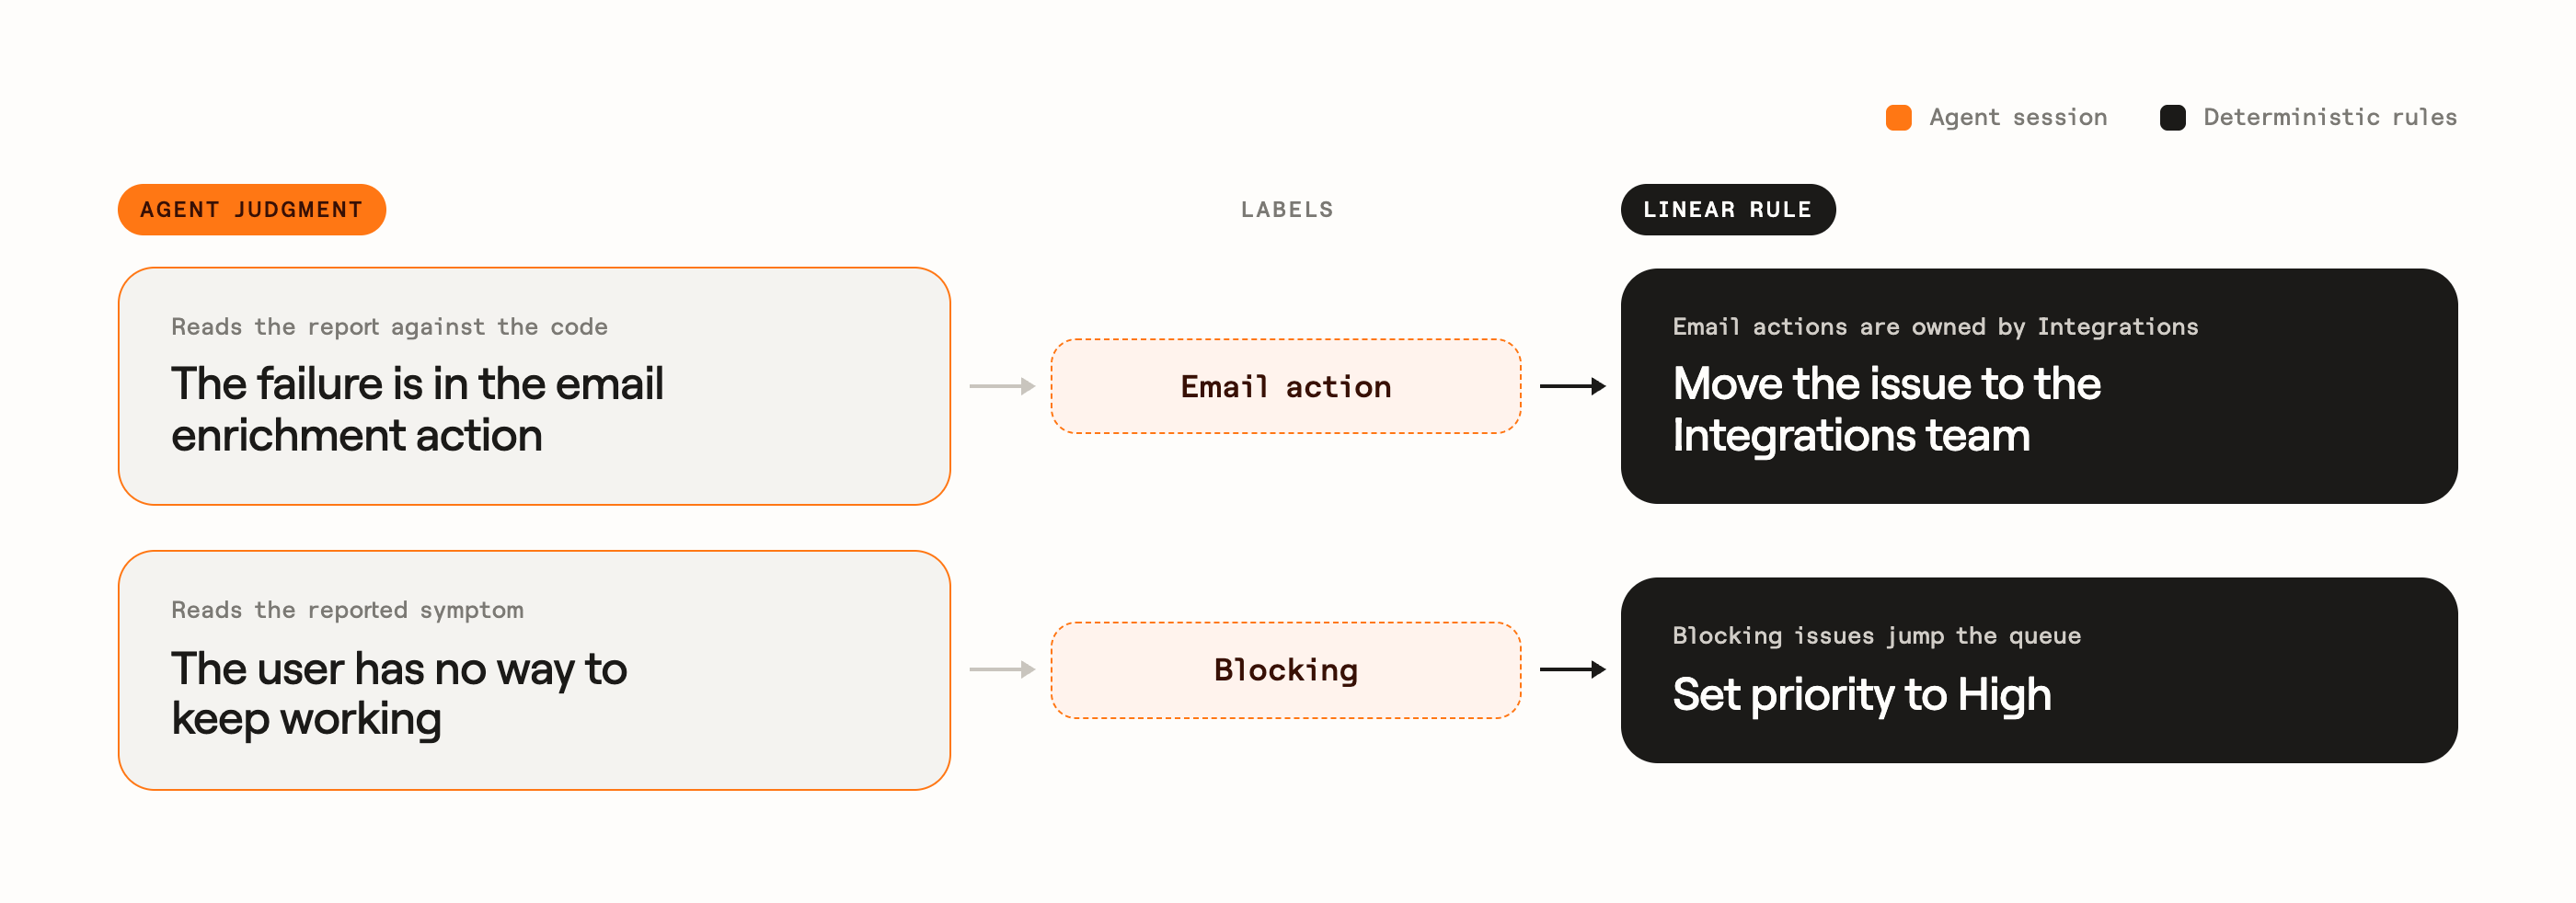
Nous gérons la délégation des pouvoirs en permettant à Devin d’appliquer un large éventail d’étiquettes à la tâche Linear, mais les Action comme la définition des priorités et l’attribution d’équipes d’ingénierie restent dans Linear. Elles utilisent ces étiquettes comme entrée et, avec les autres métadonnées collectées au moment du rapport, déclenchent les Action nécessaires.
Qu’est‑ce qui a changé ?
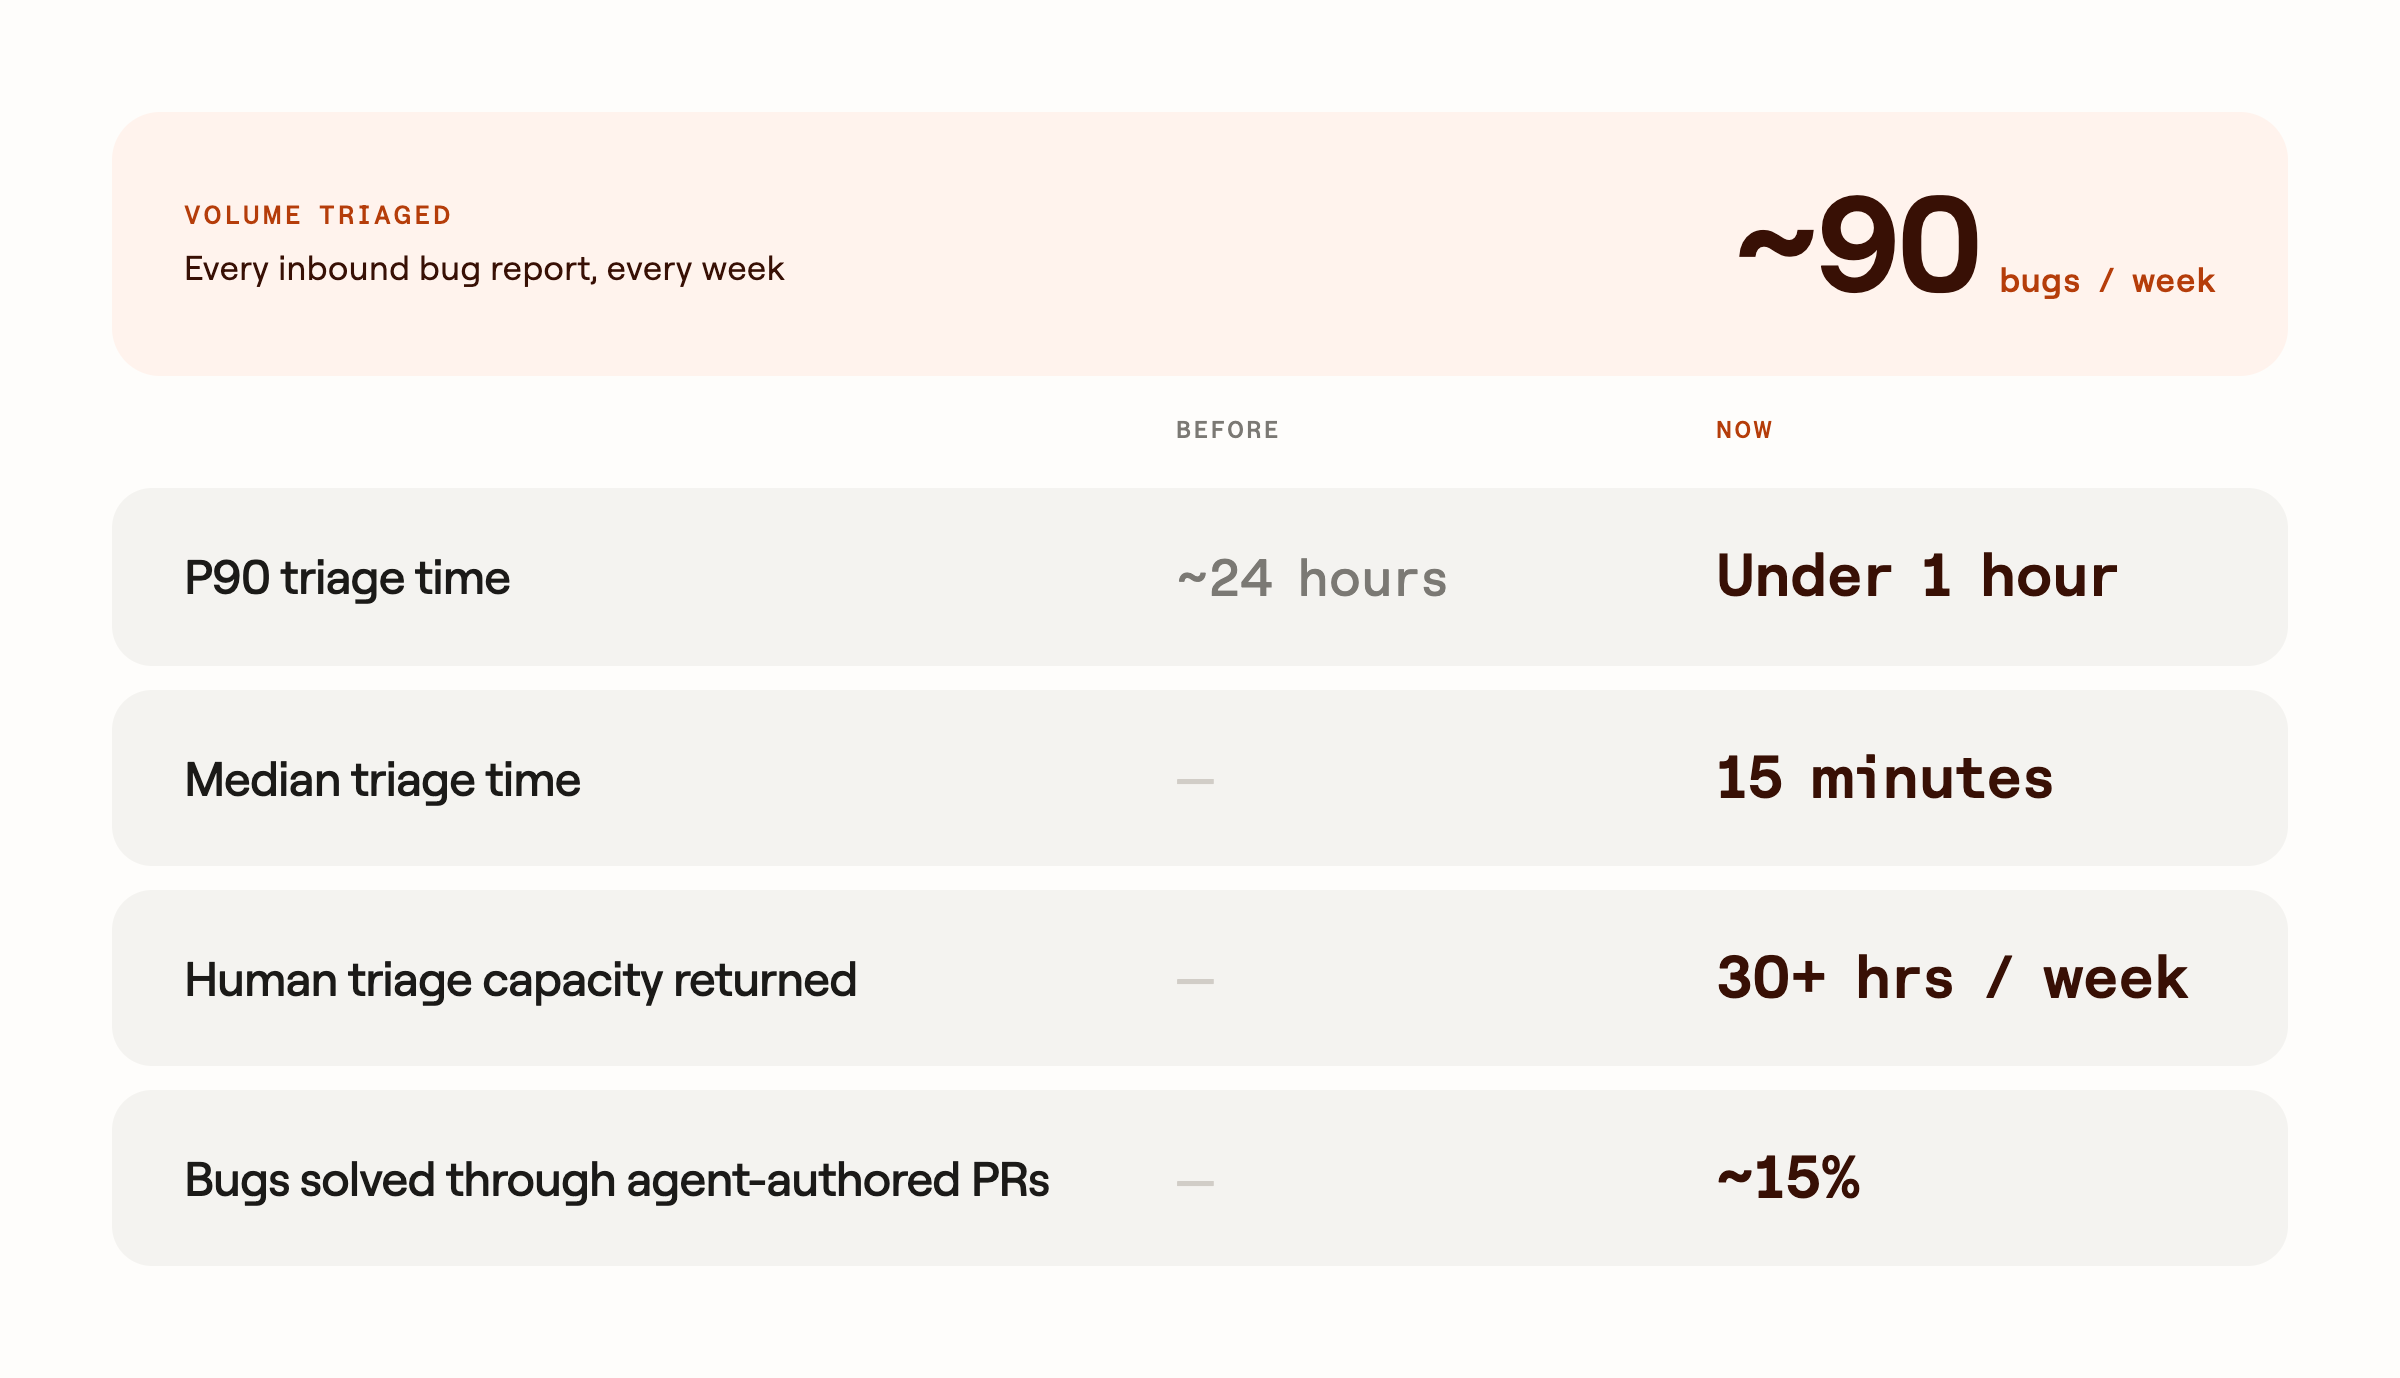
La vitesse est le résultat le plus visible, mais les économies d’attention en ingénierie sont encore plus importantes.
Les ingénieurs passent moins de temps à surveiller les files d’attente, à rassembler le contexte et à refaire les premières investigations. Ils n’ont plus à basculer entre les fils de bugs. Ainsi, ils peuvent se concentrer davantage sur les nouvelles fonctionnalités sans compromettre notre réactivité aux bugs.
Quand un ingénieur doit réellement intervenir, le Signal est plus fort et la tâche plus claire. Le problème apparaît avec son impact, le résultat de l’enquête, les chemins de code concernés, les preuves, le degré de confiance et un propriétaire clairement identifié. Les pannes urgentes se démarquent, au lieu de se perdre parmi les doublons, les solutions de contournement connues et les rapports qui manquent encore de contexte de base.
Quelle est la prochaine étape ?
Vous avez peut-être remarqué qu’on ne parle pas d’IA qui analyse les journaux de production dans la description de notre système. C’est parce que notre agent de triage n’a pas encore accès à ces journaux (et on espère que ça rend les résultats d’autant plus impressionnants).
Bien que l’équipe de Clay avance rapidement et adopte de nouveaux outils pour livrer du code, nous restons très vigilants sur la sécurité à l’ère de l’IA. Le produit de Clay est une plateforme, ce qui fait que nos journaux contiennent souvent des informations confidentielles. Pour exploiter correctement ces données, il faut parfois accéder à certaines de nos informations privées, et un agent peut réaliser de nombreuses opérations qui touchent directement ou indirectement Internet (demandez à OpenAI et Hugging Face !). Ces trois piliers constituent le trifecta létal de Simon Willison et ont été à l’origine de dizaines de violations de sécurité documentées ces dernières années.
Nous avons planifié des travaux pour combler cet écart. C’est un projet mené par notre équipe DevEx, pas un simple connecteur MCP à deux clics que n’importe qui active. Ainsi, nous pouvons résoudre le problème d’accès sûr et illimité de l’IA à nos sources de données sensibles, quel que soit le cas d’usage.