



















Web scraping est votre passe‑port pour exploiter d’énormes volumes de données en ligne et éliminer les recherches manuelles chronophages.
En quelques clics seulement, vous obtenez des informations qui constituent une base solide pour générer des Lead, étudier le marché et la concurrence, et développer votre entreprise.
Il y a plein de poissons dans l’océan du web scraping, et si vous cherchez à optimiser les coûts tout en restant flexible, les outils open source sont une excellente option. 🧑💻
Même si le filtre open‑source restreint un peu vos choix, vous avez encore plein d’alternatives. Pour vous aider à saisir leurs avantages et inconvénients, notre équipe a dressé cette liste d’excellents outils de web scraping parmi les solutions open‑source.
Nous avons aussi trouvé une alternative potentiellement supérieure , plus efficace. 🥊
En bref :
- Les cinq meilleurs outils open source de Web scraping sont Scrapy, Beautiful Soup, PySpider, Apache Nutch et Heritrix — chacun convient à des cas d’usage et à des niveaux techniques différents.
- Les scrapers open source sont gratuits et flexibles, mais la plupart demandent des compétences en programmation (Python ou Java) et impliquent des compromis sur la gestion du JavaScript, la scalabilité ou la sécurité.
- Si vous avez besoin de scraping, d’enrichissement, de prospect et de personnalisation de campagnes sans écrire de code, Clay est une alternative sans code à envisager.
- Clay's Claygent (un Web scraping basé sur l’IA), Extension Chrome et les templates prêts à l’emploi vous permettent d’extraire et de normaliser des données, même sans compétences en programmation.
Comment nous avons choisi les meilleurs outils open source de web scraping
Nous voulions nous assurer que chaque critique de cet article soit objective et dépourvue de biais, c’est pourquoi notre équipe a conçu une approche unique :
- Nous avons passé en revue les fonctionnalités de dizaines de scrapers web open source pour en saisir les points forts et les limites ✔️
- Nous avons sollicité notre réseau d’experts du secteur et influenceurs pour recueillir leurs recommandations et leurs précieux retours ✔️
- Nous avons parcouru les plateformes d’avis populaires comme Capterra et G2 pour identifier les webscrapers open source les plus prisés des utilisateurs ✔️
Nous pouvons sélectionner les meilleurs scrapers web open source, mais nous ne pouvons pas deviner vos besoins précis. Pour choisir intelligemment, examinez les critères du tableau ci‑dessous.
| Facteur | Pourquoi c’est important |
|---|---|
| 🧘 Simplicité d’utilisation | Si vous n’êtes pas développeur et que vous n’avez aucune compétence en codage, choisissez un outil simple, sans courbe d’apprentissage raide, qui ne nécessite pas des mois de formation intensive. |
| 💰 Tarif | L'outil idéal ne doit pas peser sur votre budget. Il doit proposer un plan gratuit à vie ou un essai gratuit, ainsi que plusieurs options tarifaires. |
| ⚙️ Options supplémentaires | C’est toujours une bonne idée de choisir des outils qui vont au‑delà du simple scraping et qui offrent d’autres fonctionnalités pour simplifier vos processus et centraliser votre travail. |
| 🧑🤝🧑 La taille de ton équipe | Trouvez un outil qui accompagne toute votre équipe sans freiner la croissance de votre entreprise |
Top 5 des outils de Web scraping open source : revues détaillées
Notre approche en trois étapes pour analyser les web scrapers open source a produit une liste des cinq meilleures options :
- Scrapy
- Une soupe magnifique
- PySpider
- Apache Nutch
- Heritrix
📌 Si vous ne voulez pas vous cantonner aux solutions open source et cherchez plus de fonctionnalités, nous vous présentons une autre excellente alternative de Web scraping : Clay.
1. Scrapy

Scrapy occupe le trône du Web scraping open source. Il est écrit en Python}, donc vous pouvez l’installer et le lancer comme n’importe quel autre paquet Python. 👑
Même si Scrapy sert surtout au Web scraping, il offre deux autres usages :
- Extraire des données via des API
- Exploration web polyvalente
Pour extraire des informations d’une page web avec Scrapy, il faut écrire des spiders, définir comment le site sera parcouru, planifier le crawl et récupérer des données structurées.
Vous allez adorer la capacité de Scrapy à traiter plusieurs requêtes simultanément. Vous n’avez pas besoin d’attendre qu’une requête se termine pour en lancer une autre.
Si vous voulez un support d’extensibilité solide, Scrapy l’offre. Différents middlewares, extensions et Pipeline vous permettent d’ajouter vos propres fonctionnalités à l’outil.
Bien que vous puissiez ajouter des formats de fichiers dans les paramètres de l’outil pour plus de souplesse, par défaut, Scrapy vous permet de stocker les données dans :
- JSON
- CSV
- XML
Scrapy est entièrement gratuit, ce qui en fait une excellente option pour les débutants et les startups au budget limité.
Quant aux éventuels inconvénients, il faut préciser que Scrapy ne peut pas extraire le contenu dynamique seul, mais des extensions permettent de le faire. Il y a aussi une courbe d’apprentissage, surtout pour ceux qui ne maîtrisent pas Python.
| Points forts | Inconvénients |
|---|---|
✔️ Codé en Python, simple à mettre en place ✔️ Support de l'extensibilité ✔️ Plusieurs options d’export |
❌ Impossible d'extraire le contenu dynamique |
2. Beautiful Soup

Beautiful Soup est un paquet Python qui peut extraire des données de documents HTML et XML, et vous pouvez l’utiliser pour le Web scraping.
Le package fonctionne en créant un arbre d’analyse de la page web analysée selon des critères précis. Cet arbre contient des éléments Python. Vous pouvez le parcourir et le modifier pour extraire les éléments qui vous intéressent.
Beautiful Soup est reconnu pour sa facilité d’utilisation. Sa syntaxe intuitive séduit même les non‑programmeurs et les débutants en scraping. Le package reste très puissant et peut gérer des HTML manquants ou corrompus en les interprétant pour extraire les données dont vous avez besoin. 💪
Si vous débutez avec Beautiful Soup, vous apprécierez sa immense communauté. Vous trouverez facilement une documentation complète ainsi que des ressources sur ses fonctionnalités et ses usages.
En termes d’inconvénients, Beautiful Soup ne gère pas les requêtes simultanées} aussi bien que Scrapy. Donc, si vous cherchez un outil pour du scraping à grande échelle ou complexe}, Beautiful Soup n’est pas la meilleure option. Un autre point faible : il ne prend pas en charge JavaScript, ce qui limite ses possibilités.
| Points forts | Inconvénients |
|---|---|
✔️ Simple d’utilisation ✔️ Idéal pour des tâches de scraping simples ✔️ Appuyé par une vaste communauté |
❌ Ne peut pas gérer les requêtes simultanées ni le JavaScript |
3. PySpider

PySpider est un crawler web open source écrit en Python. La plateforme propose sa propre interface web qui vous permet de :
- Modifier les scripts
- Surveillez les tâches
- Afficher les résultats
Si vous devez extraire une page web à des moments précis ou plusieurs fois sur une période donnée, vous apprécierez l’option planification de PySpider. Elle vous permet de programmer les tâches de scraping à l’avance et de ne rien manquer d’important.
Une autre option pratique, c’est gérer les requêtes concurrentes. Vous pouvez lancer plusieurs tâches de scraping en même temps, ce qui augmente votre efficacité. En plus, cela permet de parcourir les pages JavaScript, offrant une couverture de scraping exceptionnelle.
PySpider et ses options sont très bien documentés, ce qui vous permet de trouver rapidement les réponses à vos questions. Cela dit, la courbe d’apprentissage et la configuration restent complexes, donc ce n’est pas la meilleure solution si vous n’avez pas de compétences en code ou d’expérience en scraping.
| Points forts | Inconvénients |
|---|---|
✔️ Planificateur de tâches ✔️ Peut parcourir les pages JavaScript ✔️ Documentation claire |
❌ Courbe d’apprentissage abrupte et mise en place compliquée |
💡 Astuce pro : Si vous cherchez une solution de scraping sans code, Clay est une excellente option.
4. Apache Nutch

Connu pour son extensibilité et sa capacité à évoluer, Apache Nutch est un autre crawler web open source très utilisé.
Le robot d’indexation est écrit en Java et repose sur le framework Apache Hadoop et permet de traiter aisément de gros volumes de données sur des clusters d’ordinateurs. Grâce à cela, Apache Nutch gère les projets de scraping à grande échelle sans perte de performance. Il convient aussi aux petits jobs de scraping.
Apache Nutch inclut plugins intégrés :
- Apache Tika pour analyser
- Apache Solr pour indexer vos données
Comme le crawler est extensible et possède une architecture modulaire, les utilisateurs peuvent aussi configurer des implémentations personnalisées pour l’analyse, le filtrage HTML ou le scoring, et créer leurs propres plug‑ins. 🔌
La plateforme bénéficie d’une large communauté et d’une documentation complète, ce qui vous permet de trouver rapidement des réponses et de régler les problèmes. Comme les autres solutions listées, elle est gratuite. 💲}
En ce qui concerne les inconvénients, certains utilisateurs signalent que Apache Nutch consomme trop de mémoire et de CPU, il faut donc une infrastructure solide pour le faire tourner.
| Points forts | Inconvénients |
|---|---|
✔️ Idéal pour le scraping à grande échelle ✔️ Architecture modulaire ✔️Documentation complète et communauté active |
❌ Consommation élevée de mémoire et de CPU |
5. Heritrix

Heritrix est un autre scraper web open source écrit en Java. Son objectif principal est l’archivage web : il collecte des données d’Internet sous forme d’archives pour les préserver, que ce soit pour les chercheurs ou le grand public.
Heritrix respecte les directives d’exclusion robots.txt et les balises Meta nofollow, donc il n’essaiera pas d’accéder aux pages, contenus ou liens non autorisés par le site que vous essayez de récupérer. Cela garantit que vous scrapez toujours de manière éthique sans enfreindre aucune règle ou loi. 👌
Le système propose une interface web, où vous pouvez piloter le processus de scraping et repérer les éventuels problèmes ou retards.
Heritrix est totalement gratuit, et vous pouvez le redistribuer ou le modifier sans problème.
Bien qu’il soit excellent pour collecter toutes sortes de données, Heritrix a déjà rencontré des problèmes d’exploration et de stockage de contenu dupliqué par le passé, ce qui peut représenter un frein important pour certains utilisateurs.
| Points forts | Inconvénients |
|---|---|
✔️ Conçu pour archiver le Web ✔️ Respecte les directives d’exclusion de robots.txt et les balises Meta nofollow ✔️ Interface web |
❌ Risque de contenu dupliqué lors du crawl |
Avantages et limites des outils de web scraping open source
Même si les outils open source offrent de nombreux avantages, ils ont aussi leurs inconvénients. Les examiner de plus près vous aidera à voir si c’est la bonne option pour vous. Consultez le tableau ci‑dessous pour un aperçu des atouts et des limites.
| ✅ Avantages | ❌ Limitations |
|---|---|
| Coûts réduits : Les outils open source sont généralement gratuits ou très abordables | Facilité d’utilisation : Utiliser des outils open source demande souvent des compétences en codage ou, au minimum, une bonne maîtrise des langages de programmation et des technologies associées. |
| Pas de verrouillage fournisseur : Vous pouvez arrêter d’utiliser des outils open source quand vous le souhaitez, sans frais supplémentaires ni migration compliquée | Compatibilité : Certains outils propriétaires ne fonctionnent pas avec les plateformes open source |
| Flexibilité : Vous pouvez modifier le code source pour adapter le programme à vos besoins | Sécurité : Les hackers et cybercriminels peuvent accéder au code et, le cas échéant, aux données sensibles ou privées |
Quelles alternatives aux scrapers web open source ?
Si vous ne voulez pas sacrifier la sécurité, la compatibilité ou la facilité d’utilisation, pensez à d’autres solutions de web scraping. Des outils spécialisés avec des fonctions avancées de web scraping sont votre meilleur choix. Ils extraient n’importe quel type de données, de n’importe quel site, en quelques secondes. ⏩
Certains outils vont même aller plus loinscraping de données et offrent des options pour :
- Enrichissement
- Prospection
- Personnalisation de campagne
Si vous cherchez un tel outil, Clay est un excellent choix. Cette plateforme d’infrastructure GTM est simple à utiliser, offre des fonctionnalités avancées et propose des tarifs abordables pour optimiser vos flux de travail. 😍
🚨 Vous voulez voir les fonctionnalités de scraping de Clay de vos propres yeux ? Regardez cette vidéo :
Comment Clay peut‑il vous aider à extraire des données ?
En tant que plateforme d’infrastructure GTM de premier plan, Clay propose plusieurs fonctionnalités de scraping qui vous aident à explorer chaque recoin d’internet et à trouver les informations dont vous avez besoin.
L’une des options phares de la plateforme est Claygent, un scraper web basé sur l’IA. Dites à Claygent ce dont vous avez besoin, il parcourra chaque site pour dénicher l’information. Il suffit de saisir quelques prompts simples dans le champ Mission de Claygent, le reste est pris en charge. 😎

En plus de extraire des données de sites web, Claygent peut aussi lire et résumer des PDF}, vous pouvez également extraire des informations des documents. Vous pouvez vérifier la logique derrière chaque réponse de Claygent, ce qui vous assure une précision à 100 %. 🥰
Une autre fonctionnalité de scraping notable dans l’arsenal de Clay est l’extension Extension Chrome. Elle peut extraire des informations de n’importe quel site web et les placer dans un tableau pour faciliter la navigation et le travail ultérieur, permettant à votre équipe de se concentrer sur d’autres aspects précieux de vos campagnes commerciales. ⌛
Web scraping templates sont une autre raison pour laquelle Clay se démarque de ses alternatives. Utilisez ces Web scraping templates pour gagner du temps lors de l’exécution de tâches de scraping spécifiques, comme :
- Collecte d’annonces Indeed pour connaître le nombre de sites d’entreprise
- Déterminez le nombre de postes ouverts et d’employés depuis l’URL d’une entreprise
- Trouver des entreprises locales et leurs coordonnées sur Google Maps
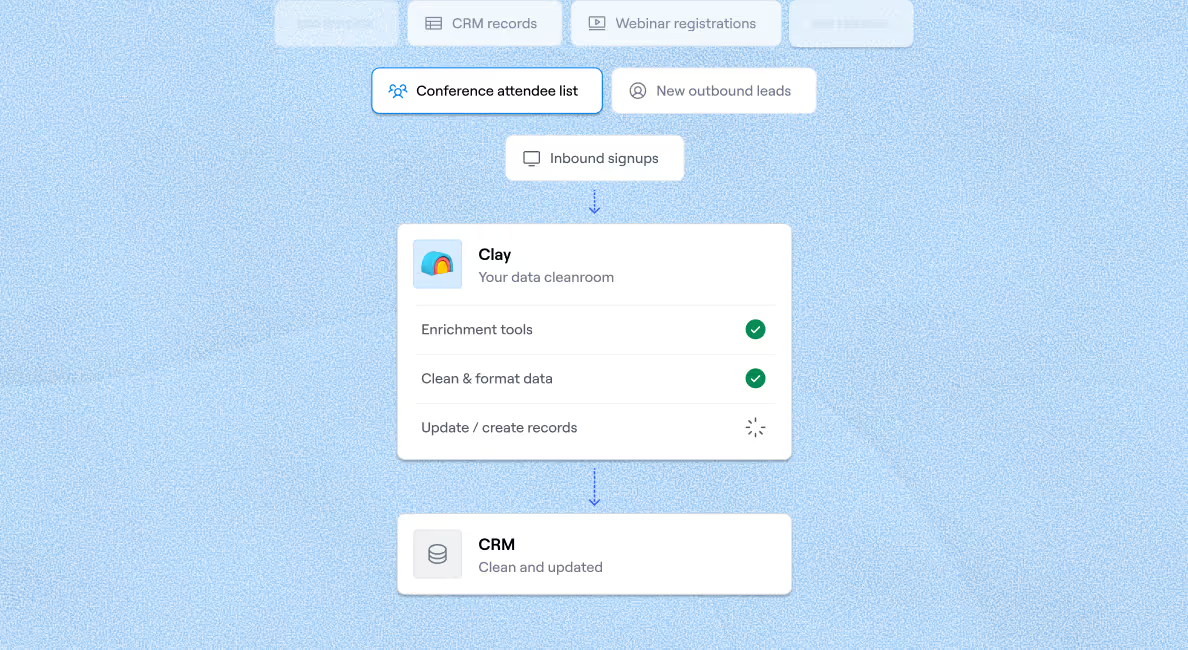
Un problème courant du web scraping, c’est l’uniformité des données. On se retrouve souvent avec des noms, des titres, des lieux ou d’autres champs incohérents. Clay vous aide à résoudre ce problème grâce à ses options de formatage des données qui nettoient les données extraites et les organisent dans un tableau. Cette fonctionnalité vous permet de normaliser automatiquement des points de données tels que :
- ✔️ Prénom et nom
- ✔️ Nom de l’entreprise
- ✔️ Intitulé du poste
- ✔️ Domaine
- ✔️ Lieu
D’autres fonctionnalités Clay qui vous plairont

Formidables options de scraping ne sont qu’une partie de l’offre de Clay.
Contrairement à beaucoup de ses alternatives, qui ne puisent les données que d’une seule base, Clay peut accéder à plus de 50 d’entre elles, ce qui vous permet de dénicher même les informations les plus pointues. Cela assure une couverture de données exceptionnelle. Vous pouvez extraire toutes sortes de données de pratiquement n’importe quel recoin du web.
En dehors de cela, Clay propose de nombreuses autres options utiles pour vous aider à simplifier vos flux de travail et gagner du temps, comme :
| Fonctionnalité | Explication |
|---|---|
| 🌊 Enrichissement en cascade | Accédez aux bases de données une à une pour couvrir le plus possible tout en maîtrisant les coûts : vous ne payez que les données réellement obtenues |
| 🤖 Enrichissement IA | Exploitez ChatGPT pour résumer la recherche et tirer des conclusions. Entraînez l’IA avec Clay pour améliorer les performances. |
| 📧 outil de création d'e-mails IA | Servez‑vous des données collectées pour rédiger des e‑mails ultra‑personnalisés à vos Lead et épatez‑les avec vos talents de recherche. |
Bien qu’il propose des options avancées qui peuvent faire évoluer votre entreprise, Clay est incroyablement facile à configurer et à utiliser. Vous n’avez pas besoin d’un diplôme en programmation ni de connaissances en Python ou JavaScript pour exploiter les options de Clay.
Découvrez ce qu’un·e utilisateur·rice dit de Clay :

Créer un compte Clay
La seule action qui reste à faire est de créer votre compte Clay, et cela ne vous prendra pas longtemps :
- Visitez la signup page 👈 de la plateforme
- Donnez les infos requises
- Explorez les options de Clay !
Clay propose un plan gratuit à vie qui vous permet d’explorer la plateforme, ses options et ses Intégration sans frais, pour voir si ça vous convient. Si ça vous plaît, vous pouvez choisir l’un des plans payants présentés ci‑dessous :
| Plan | Prix |
|---|---|
| Launch | 185 $/mois |
| Growth | $495/mois |
| Entreprise | Personnalisé |
Tous les forfaits, y compris le gratuit, offrent utilisateurs illimités, pour que vous et toute votre équipe puissiez profiter de Clay. 🥰
Si vous n'êtes pas encore certain que Clay soit la bonne solution et que vous voulez en savoir plus, visitez Clay University pour des présentations détaillées des fonctionnalités de la plateforme. Nous vous conseillons aussi de rejoindre la communauté Slack et de vous abonner à la newsletter pour découvrir les différentes utilisations de Clay et recevoir les dernières nouveautés. 📥
FAQ
Quel outil open source de web scraping convient le mieux aux débutants ?
Beautiful Soup est l’option la plus accessible aux débutants de cette sélection. Sa syntaxe claire fonctionne même sans compétences en programmation, et la communauté est vaste, avec une documentation détaillée. Cela dit, elle convient surtout aux projets de scraping simples ; elle ne gère ni le JavaScript ni les requêtes simultanées.
Un de ces scrapers open source peut‑il traiter des pages rendues en JavaScript ?
PySpider peut explorer les pages JavaScript, ce qui lui donne un net avantage sur Scrapy et Beautiful Soup pour le contenu dynamique. Scrapy ne gère pas le contenu dynamique par défaut, mais on peut ajouter des plug‑ins pour combler cette lacune.
Quelle différence y a‑t‑il entre un scraper web et un crawler ?
Un web scraper récupère des données précises sur les pages, tandis qu’un robot d’exploration parcourt le web pour indexer ou archiver le contenu. Parmi les outils de cette liste, Scrapy, Apache Nutch et Heritrix offrent ces deux fonctions, chacun à son niveau.
Quand vaut‑il la peine d’utiliser un outil no‑code plutôt qu’un scraper open source ?
Si votre équipe ne maîtrise pas Python ou Java, ou si vous avez besoin d’un scraping couplé à de l’enrichissement, de Prospect et à la personnalisation des campagnes, un outil sans code est la solution la plus rapide. L’extension Chrome de Clay et l’Extension Chrome de Clay vous permettent d’extraire et de normaliser les données sans écrire de code.