


















Le scraping manuel de sites web est monotone, source d’erreurs et très chronophage. Vous devez ouvrir chaque page une à une et copier‑coller les données utiles, ce qui ne le rend viable que pour de petits projets.
Si vous devez extraire plus que quelques pages web, il vous faut un logiciel spécialisé d’extraction de données. Un tel outil peut récupérer des données sur des milliers de pages en quelques minutes, vous permettant de automatiser le processus de collecte de données. ⌚
Pour vous aider à choisir le logiciel de screen scraping idéal, ce guide vous fait découvrir les programmes les mieux classés et souligne quelques critères à prendre en compte lors de la comparaison .
En bref :
- Avant de vous lancer, assurez‑vous que le meilleur logiciel de scraping de données répond à vos critères de facilité d’utilisation, de scalabilité, de fonctionnalités, d’**Intégration** et de prix.
- Ce guide passe en revue 7 outils : Clay, ScraperAPI, APIfy, ParseHub, Bright Data, Diffbot et Octoparse, chacun avec ses forces et ses compromis.
- Clay se démarque en réunissant le scraping alimenté par l’IA (Claygent), plus de 50 fournisseurs de données, l’enrichissement en cascade et les intégrations d’outreach, le tout sur une même plateforme.
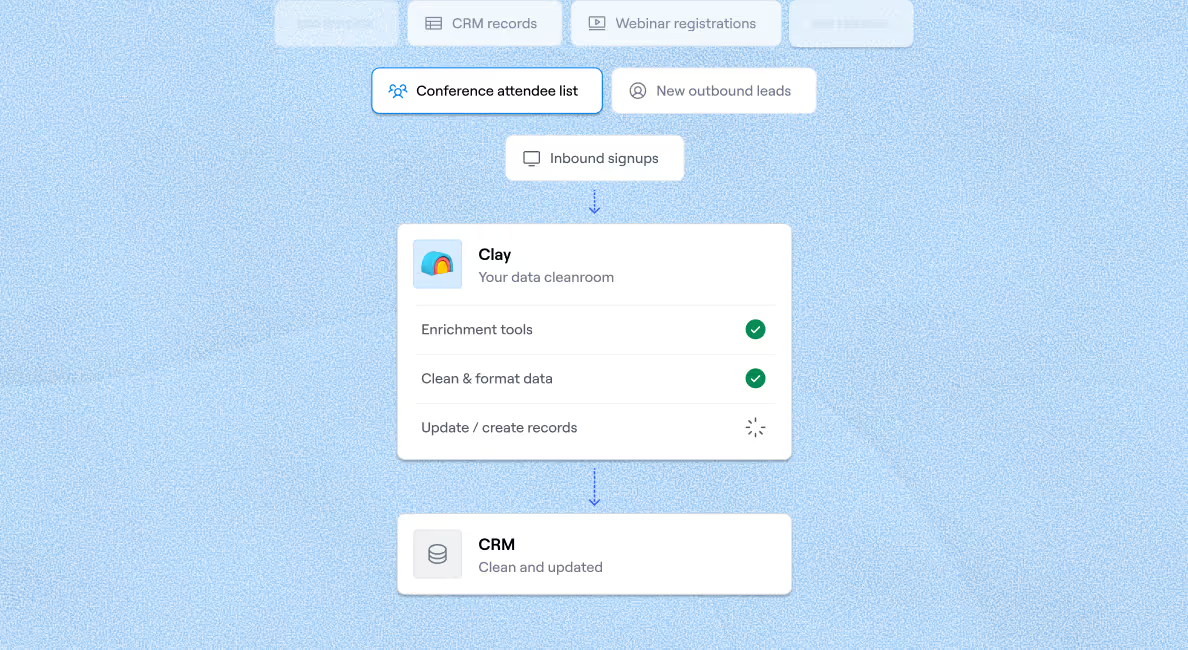
- Si votre objectif est d’obtenir des données propres et enrichies pour vos campagnes ou votre prospect, choisissez des outils qui vont au‑delà de l’extraction brute et qui facilitent les flux d’enrichissement des données.
Comment choisir le meilleur logiciel de scraping de données
Pour vous offrir un avis complet et impartial, notre équipe a adopté une approche originale qui implique :
- Testant des dizaines de programmes de web scraping pour saisir leurs fonctionnalités et leurs capacités
- Consulting notre réseau de professionnels et d’influenceurs du secteur pour recueillir leurs avis sur chaque logiciel de scraping de données
- Analyser avis clients sur des plateformes comme G2, Capterra et Product Hunt pour comprendre ce que les utilisateurs pensent de chaque programme de Web scraping
Cela dit, chaque programme de Web scraping a ses forces et ses faiblesses propres qui peuvent ou non convenir à votre équipe. Pour choisir le bon logiciel de capture d’écran, comparez‑les selon les critères suivants :
| Facteur | Pourquoi c’est important |
|---|---|
| ⚡ Simplicité d’utilisation | Privilégiez les solutions low‑code ou sans code, sauf si vous devez créer un outil de scraping sur mesure avec des fonctionnalités spécifiques. |
| 📈 Évolutivité | Choisissez un logiciel de collecte de données évolutif pour répondre à vos besoins futurs, même lorsqu’ils varient. |
| ⚙️ Fonctionnalités | Optez pour un outil doté de fonctionnalités supplémentaires afin de ne pas perdre de temps ni d’argent à transférer les données d’une plateforme à l’autre. Privilégiez les scrapers capables d’enrichir les données et de combler les éventuels manques. |
| 🔗 Intégrations | Choisissez un outil qui s’intègre à votre stack technologique existante pour réduire l'Interruption de service et simplifier les flux de travail. |
| 💲 Tarifs | Choisissez un logiciel à prix transparent qui rentre dans votre budget. Idéalement, l’entreprise propose un plan gratuit pour tester ses fonctionnalités avant de vous engager. |
7 meilleurs outils de scraping de données, évalués
Après avoir analysé des dizaines de programmes de web scraping, notre équipe a sélectionné les sept présentés ci-dessous :
- Clay
- ScraperAPI
- APIfy
- ParseHub
- Bright Data
- Diffbot
- Octoparse
1. Clay

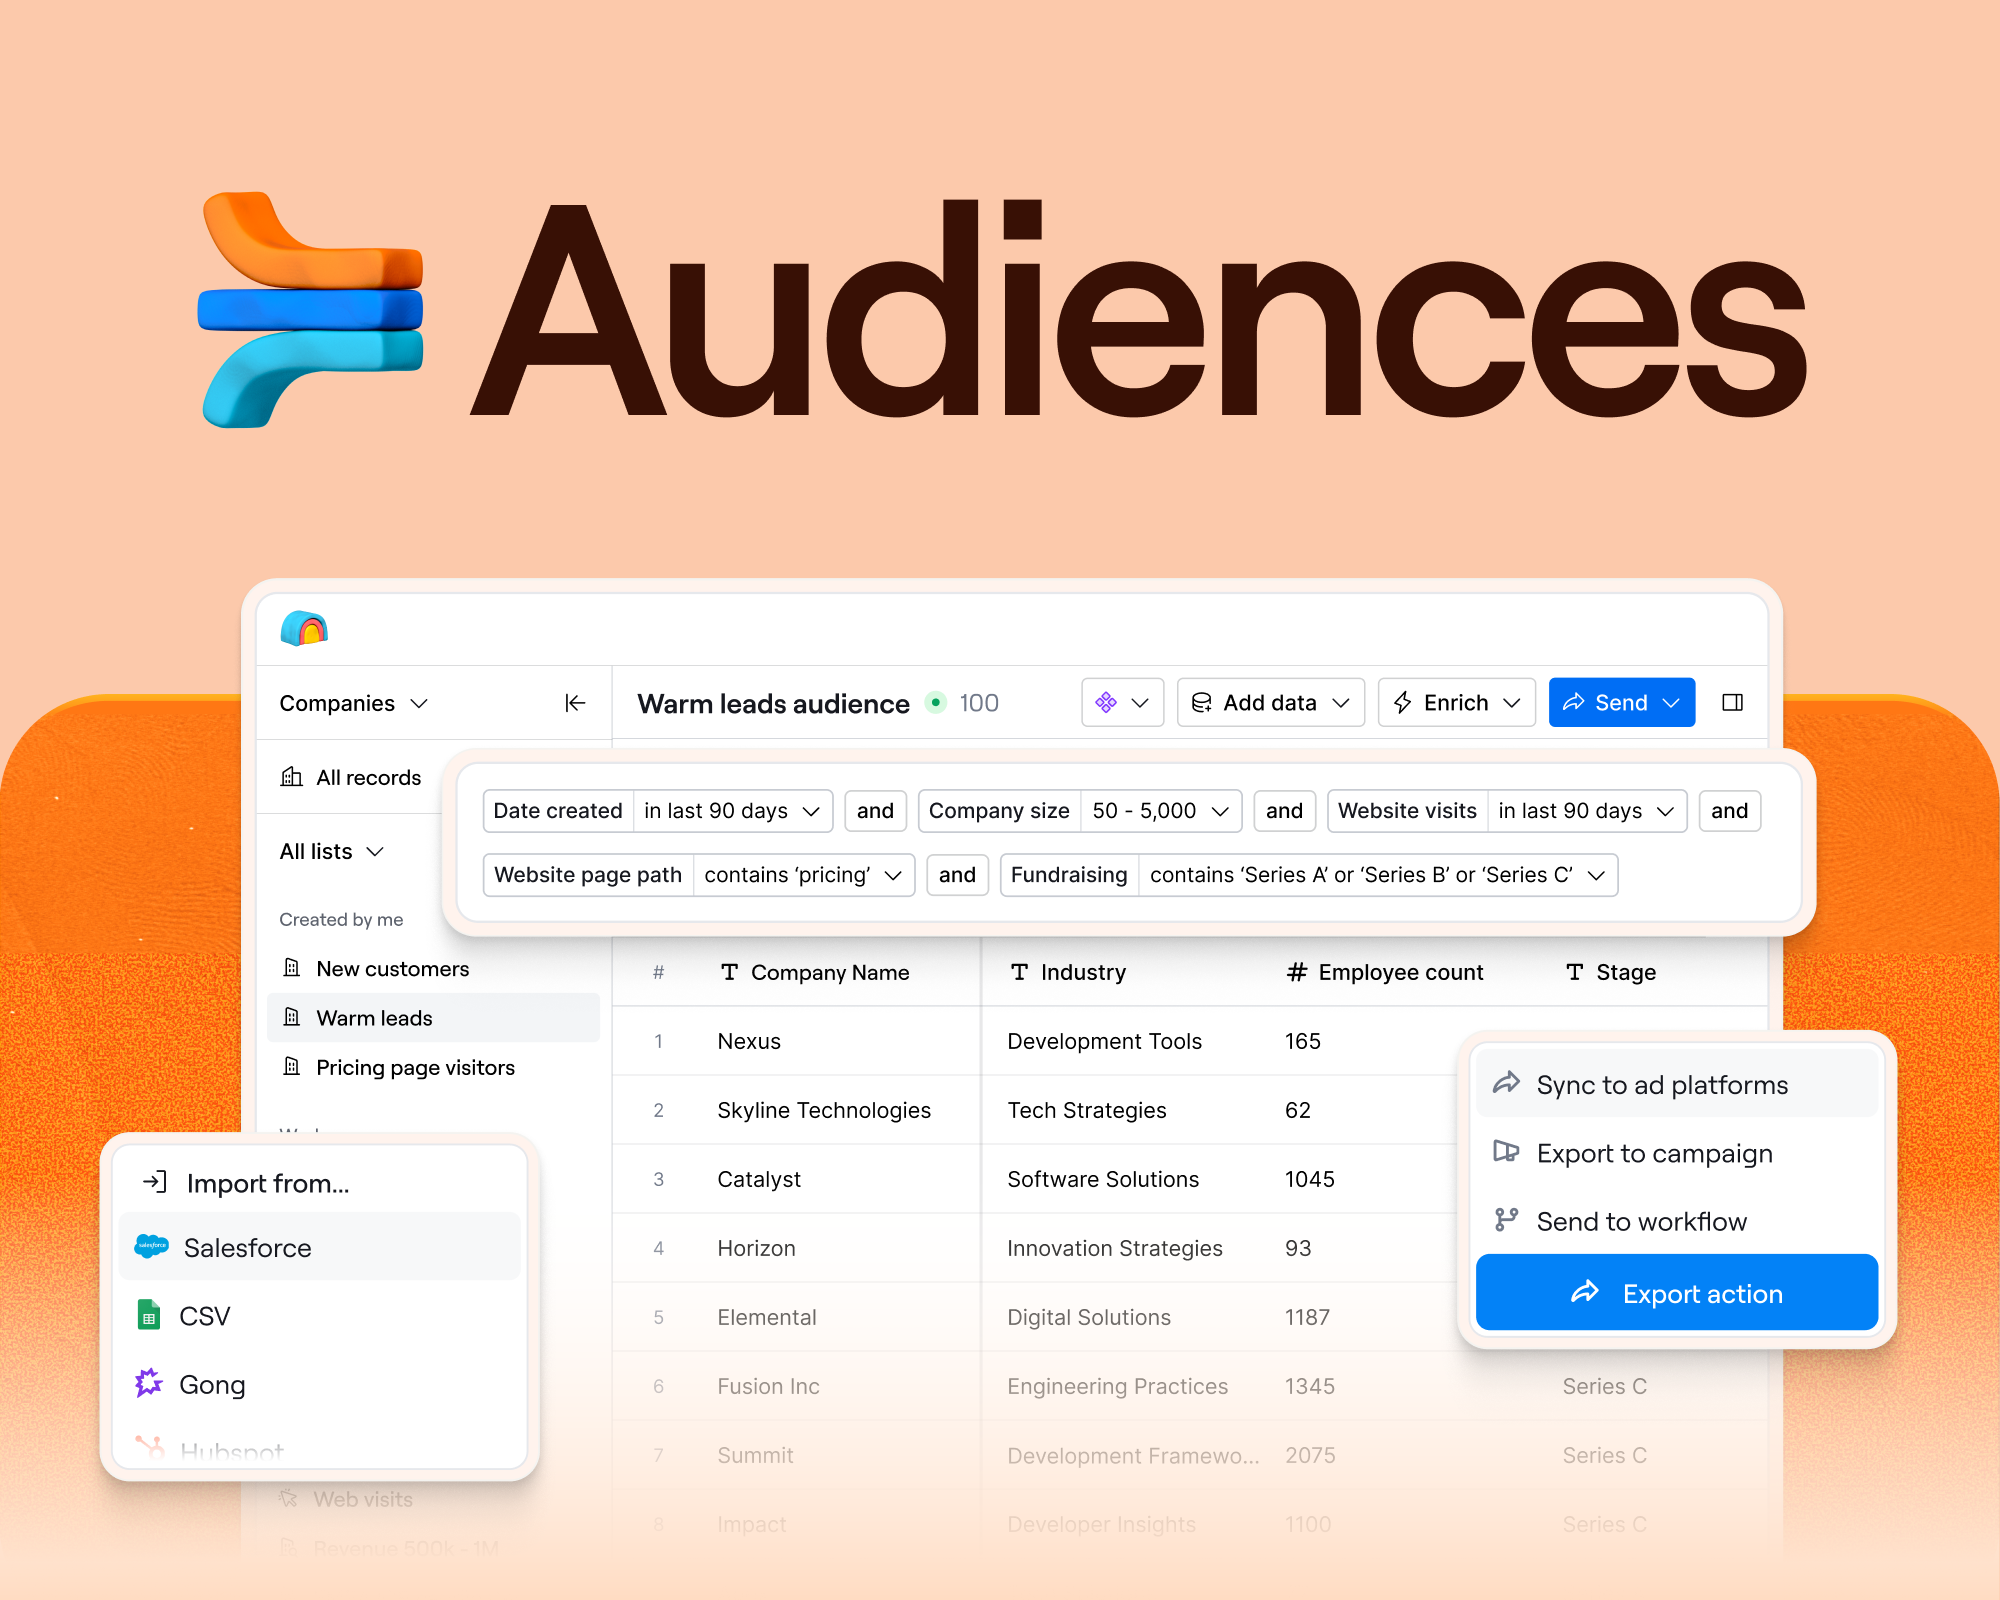
Clay est une plateforme complète d’engagement commercial et enrichissement de données avec de solides capacités de Web scraping. Parmi ses nombreuses fonctionnalités figurent deux outils polyvalents extraction de données : Claygent et l’Extension Chrome Clay.
Claygent est l’assistant IA natif de la plateforme. Ce scraper IA peut parcourir n’importe quel site, extraire et résumer les données, et fournir un retour à partir d’une simple requête ou question. Utiliser Claygent, c’est aussi simple que de demander :
- Combien de bureaux [company] possède‑t‑elle ?
- Votre [entreprise] a‑t‑elle déjà racheté une autre société ?
- Qui sont les investisseurs de [company] ?
Si cela ne correspond pas exactement, vous pouvez recourir à l’extension Clay Extension Chrome, qui vous permet de scraper des sites web au fur et à mesure que vous les visitez. En ouvrant une page, elle peut soit :
- Servez‑vous de la cartographie des données d’autres personnes pour déterminer comment connecter et organiser différents types d’informations
- Détectez automatiquement les jeux de données et récupérez‑les immédiatement
- Cartographiez manuellement la liste de données et indiquez les points de données dont vous avez besoin.

Une fois le scraping terminé, vous pouvez profiter des 50+ fournisseurs de données intégrés à Clay pour enrichir vos données et même utiliser l’IA afin de rédiger des e‑mails ultra personnalisés}.
La plateforme propose également des Template de Web scraping pour différents types de données, comme les offres d’emploi, les évaluations et avis, les employés d’une entreprise et les postes ouverts, et bien d’autres. Si vous avez besoin de fonctionnalités supplémentaires, vous pouvez tirer parti de nombreuses Intégrations pour simplifier le scraping et automatiser toutes les étapes du processus de collecte de données. Voici quelques-unes de ces Intégrations :
- Parse Data from URL: Analysez les données d’une URL avec l’API ScrapeMagic
- Trouver des mots-clés sur un site web: Vérifiez si un site/domaine contient des mots-clés spécifiques.
- Get Products: Récupérez la liste des produits d’un site hébergé sur Shopify
- Search Google: Effectuer n'importe quel type de requête avec le moteur de recherche Google
En tant que scraper sans code, vous n’avez pas besoin d’expertise technique ni de formation particulière pour l’utiliser. Cela dit, certains utilisateurs estiment que les fonctionnalités avancées demandent du temps pour être maîtrisées.
Vous pouvez tester Clay avec son plan gratuit, et une fois que vous avez adopté les fonctionnalités, vous pouvez choisir l’un des plans payants :
- Launch : 185 $/mois
- Growth: 495 $/mois
- Enterprise : Sur mesure
| Points forts | Inconvénients |
|---|---|
✔️ Extension Chrome pour scraping data ✔️ Scraper web IA Claygent pour extraire vos données en toute fluidité ✔️ Plus de 50 fournisseurs de données ✔️ Enrichissement des données ✔️ Tous vos points de données au même endroit ✔️ Fonctionnalités de recherche et de rédaction IA |
❌ Une courbe d’apprentissage pour des fonctionnalités avancées |
2. ScraperAPI

ScraperAPI est un scraper web dynamique et simple d’utilisation qui extrait les données des pages grâce à des appels API. Grâce à une API REST intuitive, il suffit d’envoyer une requête GET avec l’URL du site et votre clé API. Il supporte les langages de programmation comme Python, Java, PHP, Ruby, Node et Bash.
L'outil se personnalise très facilement :
- Ajoutez render=true à votre payload pour récupérer des données dynamiques
- Ajoutez country_code=us pour géolocaliser les IP
- Ajoutez premium=true pour activer les proxies résidentiels
ScraperAPI propose plus de 40 millions de proxys répartis dans plus de 50 zones géographiques, vous donnant accès à des données locales. Le service gère aussi les CAPTCHA, fait tourner les IP et les en‑têtes, et offre des outils avancés de gestion d’empreintes et de contournement anti‑bot pour réduire le risque de détection. 🕵️
Cependant, le principal inconvénient souvent cité dans les avis des utilisateurs est un service client insatisfaisant. Si certains en sont satisfaits, la plupart attendent plus de 24 heures pour obtenir une réponse. D’autres signalent également un taux de réussite faible.}
ScraperAPI propose une tarification simple et équitable. Vous pouvez tester ses fonctionnalités pendant sept jours, puis choisir l’un des plans ci‑dessous.
- Hobby: $49/mois
- Startup : $149 / mois
- Business : 299 $/mois
- Enterprise : Sur mesure
| Points forts | Inconvénients |
|---|---|
✔️ Simple à mettre en place et à utiliser ✔️ Personnalisable à souhait ✔️ Des tarifs justes ✔️ Plus de 40 M de proxies |
❌ Support client insuffisant ❌ Taux de réussite faible |
3. APIfy

APIfy est une plateforme full‑stack pour créer des web scrapers, mais elle propose des centaines d’outils prêts à l’emploi appelés Actors, accessibles à tous.
Il prend en charge trois langages de programmation, dont JavaScript, TypeScript et Python, et propose des code Template, des frameworks de web scraping et des bibliothèques comme Crawlee pour réduire le temps de développement des acteurs. Une fois l’acteur créé, vous pouvez même le publier dans l’APIfy Store et gagner de l’argent.
Plus de 1 600 acteurs sont proposés, dont :
- Grattoir Google Maps
- Extracteur de produits Amazon
- Extracteur de résultats de recherche Google
- Extracteur Instagram
- Scraper Indeed
C’est simple à télécharger, modifier et utiliser. Vous pouvez les lancer depuis la console APIfy, la CLI, via l’API, ou les programmer et en exécuter autant que vous le souhaitez. Après le scraping, les résultats sont enregistrés dans des jeux de données que vous pouvez exporter au format JSON, CSV, RSS, HTML, Excel ou XML. Certains utilisateurs ont toutefois souligné les limites de cette fonctionnalité et préfèrent un export fichier plutôt qu’un jeu de données.
Pour limiter les risques de suivi ou de blocage de vos requêtes, APIfy attribue une IP résidentielle ou de datacenter différente à chaque appel.
APIfy propose des tarifs équitables, mais cela peut rester cher pour ceux qui font du scraping à petite échelle :
- Gratuit: 0 $/mois
- Starter : $49/mois
- Scale : 499 $/mois
- Business: $999/mois
- Enterprise : Sur mesure
| Points forts | Inconvénients |
|---|---|
✔️ Des centaines d’outils d’extraction prêts à l’emploi ✔️ Gagnez en publiant des acteurs ✔️ Des outils de scraping simples à créer ✔️ Plusieurs formats d’export de données |
❌ Formats de sortie restreints ❌ Des tarifs trop élevés pour les petits projets |
4. ParseHub

ParseHub est un logiciel gratuit et puissant de collecte de données qui utilise une simple opération de point-and-click pour collecter des données.} Si vous devez extraire des informations précises d’une page, cliquez simplement sur l’élément souhaité et ParseHub s’en charge. C’est une solution sans code idéale. 👨💻
Le scraper web peut extraire des données de n’importe quel site, qu’il soit complexe ou lent. Il parcourt les formulaires, ouvre les listes déroulantes et récupère sans effort le contenu dynamique, le défilement infini, les connexions, les onglets et les pop‑ups. Les résultats sont stockés sur les serveurs de ParseHub ; vous pouvez les télécharger aux formats Excel et JSON, puis les importer dans Google Sheets ou Tableau.
ParseHub propose une fonction de rotation d’IP qui change votre adresse IP dès que vous tombez sur des sites aux techniques anti‑scraping agressives. Vous pouvez programmer la collecte de données pour obtenir chaque jour, chaque semaine ou chaque mois un nouveau jeu de données. ⌚
En ce qui concerne les tarifs, vous avez quatre options :
- Gratuit: 0 $/mois
- Standard: 189 $/mois
- Professionnel : 599 $/mois
- Enterprise: Sur mesure
Notez que certains utilisateurs trouvent la solution pas conviviale et jugent les prix trop élevés. D’autres ont choisi des alternatives moins chères après l’avoir testée.
| Points forts | Inconvénients |
|---|---|
✔️ Application de bureau ✔️ Stockage cloud automatisé ✔️ Récupère les données de sites web complexes ✔️ Aucune expérience en codage n’est requise |
❌ Prix trop élevés ❌ Pas aussi convivial que d’autres solutions |
💡 Lecture bonus : Si vous cherchez le meilleur outil cloud, consultez ce guide des scrapers web cloud.
5. Bright Data

Bright Data, anciennement Luminati Networks, est une plateforme de données web qui offre un ensemble de fonctionnalités dédiées à la collecte de données, comme :}
- Web scraping APIs : des API simples d’utilisation qui donnent un accès rapide à des données structurées provenant de dizaines de domaines populaires, comme Instagram, Amazon et Zillow
- Scraping Browser: Un navigateur qui vous permet d’accéder, de naviguer et de scraper des sites cibles avec les scripts Puppeteer, Playwright et Selenium
- Web Unlocker: Un outil qui débloque l’accès à n’importe quel site public
- SERP API: Un outil qui scrape les moteurs de recherche
Si vous ne voulez pas entretenir un scraper, vous pouvez demander un jeu de données pour n’importe quel site public sur le Data Marketplace Bright Data. Ils sont disponibles aux formats JSON, NDJSON, CSV et XLSX. Vous pouvez personnaliser, enrichir et formater le jeu de données selon vos besoins de scraping. 📄
En matière de tarification, les API de Web scraping proposent un plan à l’usage qui débute à 0,001 $/enregistrement. Les autres outils de scraping sont proposés avec quatre abonnements payants, en plus de leurs modèles à l’usage :
- Micro-package: 10 $/mois
- Growth : 499 $/mois
- Business: $999/mois
- Enterprise : Sur mesure
De nombreux avis d’utilisateurs louent le support client compétent et serviable de la plateforme, mais critiquent la documentation, qu’ils trouvent un peu limitée dans certaines fonctionnalités et mal organisée. D’autres estiment que l’interface de scraping est inutilement complexe et le tableau de bord n’est pas bien agencé.
| Points forts | Inconvénients |
|---|---|
✔️ Plusieurs solutions de scraping ✔️ Un support client de qualité ✔️ Taux de réussite élevé du scraping sur les sites fortement protégés contre le scraping ✔️ Jeux de données de haute qualité à votre disposition |
❌ Documentation insuffisante ❌ Mise en page du tableau de bord trop compliquée |
💡 Pro Tip: Profitez de Clay’s Bright Data Intégration pour aller au-delà d’un ensemble de fonctionnalités et accéder à des dizaines de sources de données supplémentaires.
6. Diffbot

Diffbot est un logiciel d’extraction d’écran alimenté par l’IA qui ne nécessite aucune règle pour récupérer le contenu d’une page. Il propose l’outil Extract API qui utilise la vision par ordinateur pour lire les sites web } en deux étapes.
- Classe une page parmi vingt types possibles
- Utilisez un modèle d’apprentissage automatique pour repérer les attributs clés d’une page selon son type
C’est peut-être la meilleure solution si vous ne savez pas quel type de contenu se trouve sur le site que vous voulez scraper. En plus de l’API Extract, Diffbot propose d’autres outils pour faciliter le Web scraping et améliorer la qualité des résultats, comme :
- Crawl API: Un outil qui parcourt chaque page d’un site web, récupère les liens pertinents et les transmet à l’Extract API pour les traiter
- DQL API : un outil qui explore le Knowledge Graph de Diffbot pour trouver personnes, organisations, articles et plus encore
- Enhance API : un outil d’enrichissement de données qui complète tous les champs manquants dès que vous avez les identifiants de base d’une personne ou d’une entreprise
- API en langage naturel: Un outil qui comprend le texte brut de façon programmatique. Il peut classer le texte, identifier et extraire les entités, décomposer les phrases en leurs éléments et analyser les sentiments exprimés.
- Bulk API : un outil qui transmet un lot d’URL à l’Extract API pour les scraper
Vous pouvez utiliser ce logiciel de capture d’écran pour extraire tous les types de données du web}, y compris images, texte et vidéos, puis les exporter en JSON, CSV, XLS ou XLSX. Il génère aussi des graphes de connaissances pour vous aider à saisir les données, leur contexte et leurs liens. 📊
Notez que certains avis sur Diffbot soulignent qu’il est difficile à prendre en main et que l’utilisation de requêtes avancées peut nécessiter d’apprendre le Diffbot Query Language (DQL). Cela dit, le service client est excellent et vous accompagne tout au long du processus.
Côté tarif, Diffbot propose un plan gratuit à vie, mais vous pouvez passer à l’un des trois plans payants pour accéder aux fonctionnalités avancées.
- Startup : $229/mois
- Plus : 899 $/mois
- Enterprise : Sur mesure
| Points forts | Inconvénients |
|---|---|
✔️ Utilise la vision par ordinateur pour scanner les données ✔️ Génère du texte et du HTML propres ✔️ Propose des outils d’enrichissement de données ✔️ Met à disposition des graphes de connaissances |
❌ Pas simple à utiliser ❌ Peut nécessiter du DQL |
7. Octoparse

Octoparse est une solution de Web scraping sans code conçue pour les débutants. Elle se démarque par son interface intuitive et son fonctionnement simple : un clic, puis le scrape. En plus, plus de 60 modèles de Template sont disponibles, pour que chacun puisse l’utiliser sans écrire de code ni configurer de règles de scraping.
Quand vous le lancez, choisissez l’un des deux modes d’extraction :
- Assistant
- Tâche personnalisée (anciennement Mode avancé)
Le mode Wizard est plus simple à utiliser et suffit d’instructions pour extraire les données d’une page web. Le mode Custom Task, quant à lui, vous permet de scraper des sites complexes avec du contenu dynamique, de la pagination, des connexions et un défilement infini. 💪
Pour extraire vos données en toute discrétion et éviter la détection, Octoparse met à disposition des proxys, une rotation d’IP et la résolution de CAPTCHA, tout en vous laissant configurer manuellement vos serveurs proxy. Vous pouvez ensuite exporter les résultats dans les formats qui vous conviennent – Excel, CSV, HTML ou TXT – et les envoyer vers les bases de données de votre choix, comme SQL Server, MySQL ou Oracle.
Octoparse propose un forfait gratuit limité, mais pour exploiter toutes ses fonctionnalités, vous devez choisir l’un de ses plans payants.
- Standard: $89 / mois
- Professionnel: $249/mois
Bien qu’il excelle dans la plupart des domaines, il peut être un peu lent pour le cloud scraping, et les Template ne sont pas trop personnalisables.
| Points forts | Inconvénients |
|---|---|
✔️ Interface épurée et conviviale ✔️ Task Template ✔️ Plusieurs modes d’extraction ✔️ Extraction programmée |
❌ Lent lors du scraping cloud ❌ Templates ne sont pas entièrement personnalisables. |
Verdict final : quel logiciel de scraping de données choisir ?
Chacun de ces programmes de web scraping peut extraire les données dont vous avez besoin sur la plupart des sites, donc choisir le bon dépend de vos besoins et de vos préférences. Pour mieux cerner votre situation, posez‑vous ces quelques questions :
- Quel est mon budget ?
- De quel type de données ai‑je besoin ?
- Combien de données faut‑il scraper ?
- Est‑ce que je vais extraire des données de sites dynamiques ?
- Je veux une solution complexe, low‑code ou no‑code ?
Une fois que vous avez fait cela, pensez à l’objectif du scraping de données. Si vous avez besoin de données propres et de haute qualité, choisissez un web scraper avec des fonctionnalités d’enrichissement avancées. Il vous aidera à vérifier la précision des données et à les enrichir avec d’autres points de données. Ce type de solution est particulièrement utile dans les campagnes de prospection à froid et indispensable pour constituer des listes de qualité et identifier des prospects.
Après avoir analysé les fonctionnalités des sept plateformes que nous avons évoquées et les avoir comparées, Clay se démarque comme la solution la plus polyvalente et complète. 🏆
Avec Clay, vous bénéficiez d’une plateforme intuitive dotée de capacités solides de collecte et d’enrichissement des données, ainsi que de fonctionnalités pour créer des e‑mails hautement personnalisés. Voici un exemple de ce que les utilisateurs disent de son efficacité :

Ce qui rend Clay le meilleur logiciel de collecte de données
Clay propose trois fonctions que les autres programmes de web scraping ne peuvent qu’imaginer. Découvrez‑les dans le tableau ci‑dessous :
| Ce que Clay propose | Explication |
|---|---|
| 📜 Scraping IA | Bien que de nombreuses solutions puissent extraire des données, aucune n’est aussi élégante que Clay. Elle peut visiter n’importe quel site, trouver et résumer les informations, et rendre compte d’un simple prompt. Vous pouvez aussi utiliser l’Extension Chrome pour importer directement des personnes, des entreprises ou des offres d’emploi dans des tableaux. |
| 🏗️ Enrichissement | La plupart des web scrapers n’ont qu’une ou deux bases de données à leur disposition. Clay en possède plus de 50, dont Swordfish, Clearbit, Open AI et SignalHire. Il utilise un enrichissement en cascade pour rechercher les données séquentiellement, ce qui améliore la précision des données et renforce la personnalisation des campagnes de prospection. |
| ✉️ Prospection | Exportez les données extraites et enrichies ou exploitez‑les pour créer des messages hyper‑personnalisés afin de connecter vos Lead. Clay s’intègre à plus de 100 outils, vous permettant de transférer les e‑mails vers votre plateforme d’automatisation. |
Vous n’avez même pas besoin de faire le scraping ou l'Enrichir vous-même. Choisissez les données dont vous avez besoin (emails, numéros de téléphone, données d’entreprise, etc.) et Clay vous fournit toutes les informations recherchées en un clin d’œil.
Les personnes qui ont découvert Clay sont impressionnées par ses capacités. Voici ce qu’un utilisateur a à dire :

FAQ
À quoi sert un logiciel de scraping de données ?
Les logiciels de scraping de données extraient automatiquement les informations des sites web à grande échelle, remplaçant le processus manuel de copier‑coller page par page. Parmi les usages les plus courants : créer des listes de prospects, **Surveillance en cours** des prix des concurrents, collecter les offres d’emploi et **Enrichir** les dossiers CRM avec des données d’entreprise ou de contact à jour.
Les outils de scraping de données peuvent-ils contourner les CAPTCHAs et les protections anti‑bot des sites ?
La plupart des outils présentés offrent une gestion anti‑bot. ScraperAPI résout les CAPTCHA et fait tourner les adresses IP automatiquement. ParseHub et Octoparse proposent aussi la rotation d’IP pour éviter la détection. Bright Data propose un outil dédié, le Web Unlocker, qui permet d’accéder aux sites protégés par des mesures anti‑scraping agressives.
Quelle est la différence entre un scraper d’extension de navigateur et un scraper basé sur une API ?
Une extension de navigateur scraper (comme l’Extension Chrome Clay) s’exécute directement dans votre navigateur et vous permet d’extraire les données des pages au fur et à mesure que vous les consultez, sans aucune programmation. Un scraper basé sur une API (comme ScraperAPI) envoie des requêtes programmées vers les URL ciblées et renvoie des données structurées, ce qui le rend plus adapté aux Pipeline à grande échelle ou automatisés qui fonctionnent sans navigation manuelle.
Comment le cloud scraping fonctionne-t-il ?
Le cloud scraping lance vos tâches sur des serveurs distants, pas sur votre ordinateur. Vous pouvez ainsi programmer et faire tourner des jobs en continu, sans garder votre machine allumée. Des outils comme ParseHub stockent les résultats sur leurs propres serveurs, et Octoparse propose un mode cloud en plus de son application de bureau. Le compromis : le cloud scraping peut être plus lent ou plus coûteux, selon la plateforme.
Créez votre compte Clay
Si vous voulez explorer Clay, créez votre compte Clay en trois étapes rapides :
- Ouvrez la page d’inscription 👈
- Entrez votre nom, votre e‑mail et votre mot de passe
- Découvrez la plateforme
Pour en savoir plus sur Clay et savoir si c’est fait pour vous, explorez Clay University, rejoignez la Slack community ou inscrivez‑vous à la platform's newsletter. 🎓