


















Le Web scraping peut vraiment simplifier votre quotidien quand vous lancez des campagnes Outbound. Il vous permet d’obtenir les données dont vous avez besoin à grande échelle, sans épuiser les processus manuels. Si vous envisagez d’utiliser un web scraper pour optimiser votre flux de travail, vous vous interrogez peut‑être sur les aspects réglementaires.
En d’autres termes, vous pourriez poser une question simple : « Web scraping est‑il légal »?
Il n’y a pas de réponse unique, mais pas de panique. Ce guide fait le point et vous montre aussi des méthodes éthiques pour extraire des données du web, recueillies auprès de spécialistes du marketing et des ventes de notre réseau.
❗ Avertissement : Le scraping de données relève de notre expertise, pas du droit. Le contenu de cette page est uniquement à des fins éducatives ; consultez un·e avocat·e si vous avez besoin d’un avis juridique.
En bref :
- Web scraping est techniquement légal aux États-Unis, mais sa légalité dépend des données que vous collectez, de la façon dont vous y accédez et du respect des lois en vigueur.
- Le scraping de données publiques est généralement sans risque. En revanche, extraire des données privées, du contenu protégé par le droit d’auteur sans justification d’usage loyal, ou des informations personnelles de résidents de l’UE ou de Californie expose à de réels risques juridiques.
- Vérifiez toujours les Conditions générales d’utilisation d’un site avant de le scraper. Si vous avez accepté les Conditions générales d’utilisation en vous connectant, le scraper ce site peut vous exposer à des poursuites au titre du CFAA.
- Utiliser un outil de scraping fait sur mesure comme Clay diminue les risques juridiques et techniques par rapport aux méthodes manuelles, comme les scripts Python.
Le web scraping est‑il légal ? Les facteurs clés expliqués
Le web scraping en tant que pratique est techniquement légal puisqu’il n’existe aucune loi ou réglementation fédérale qui l’interdit. D’innombrables pages web sont extraites chaque jour à diverses fins, de la formation d’IA à la génération de Lead. Il n’y a pas eu beaucoup de conséquences juridiques liées à cette pratique, donc vous pouvez l’intégrer sans souci à votre flux de travail.
Voilà, vous pouvez lancer votre data scraper et commencer à remplir votre base de données, non ?
Pas exactement, la plupart des questions juridiques ne sont pas si simples. Même si le web scraping n’est pas formellement illégal, vous devez prendre en compte les facteurs suivants pour voir l’ensemble et rester prudent :
- Données publiques vs. données privées 🤫
- Réglementations relatives aux informations personnellement identifiables (PII) 🧑⚖️
- Conditions générales d’utilisation des sites web (ToS) 📄

Collecte de données publiques vs. informations privées
Quand on dit que le web scraping est légal, on parle spécifiquement de données publiques. Dans le contexte du scraping, cela inclut toutes les données qui peuvent être consultées sans connexion. Voici quelques exemples :
- Contenu qui n’est pas réservé aux membres du site.
- Données académiques libres et ouvertes
Si vous comptez scraper l’un des éléments ci-dessus, vous pouvez le faire sans risque juridique, à condition de respecter les lois en vigueur.
Par exemple, même du contenu public peut rester protégé par le droit d’auteur, ce qui ouvre une toute autre dimension juridique. Vous ne pouvez collecter et utiliser ces données que si cela relève de usage équitable, ce qui n’est pas toujours évident à déterminer.
En général, si vous récupérez des contenus protégés à des fins éducatives, pour couvrir l’actualité ou dans le cadre de recherches, vous pouvez invoquer le fair‑use. Vous avez peu de chances de le faire si vous collectez des données pour :
- Dupliquez‑le
- Utilisez‑le à des fins commerciales
- Distribuez‑le sans autorisation
En résumé, vous pouvez extraire des données publiques sans risque tant qu’aucune loi ne les protège n’est violée. Cela ne s’applique pas aux données privées, qui sont illégales à extraire en toutes circonstances.
Le scraping de données est‑il légal quand il s’agit d’informations personnelles identifiables ?
Le PII englobe toute information pouvant être utilisée pour identifier une personne, telle que :
- Nom
- Numéro de téléphone
- Adresse
- Date de naissance
Le scraping d’informations personnelles identifiables (PII) fait débat depuis un moment, et il n’existe pas de directives universelles sur sa légalité. Plusieurs lois de protection des données peuvent freiner un scraping sans risque, deux d’entre elles sont particulièrement importantes :
- Règlement général sur la protection des données (RGPD) dans l’UE
- Loi californienne sur la protection de la vie privée des consommateurs (CCPA) en Californie
Les deux réglementations interdisent la collecte de PII sans le consentement explicite de l’utilisateur ou sans raison légale. Cela signifie que si vous voulez récupérer les données personnelles de citoyens de l’UE ou de Californie, vous pourriez vous retrouver dans une zone grise juridique.
Les États‑Unis n’ont aucune réglementation fédérale qui limite la collecte de PII dans d’autres États, donc c’est bien plus sûr d’un point de vue juridique>.
Notez que les réglementations ci‑dessus ne concernent pas spécifiquement le web scraping (c’est‑à‑dire l’utilisation d’un outil automatisé pour collecter des données), mais toute forme de collecte de renseignements personnels. Cela confirme notre point de vue : un web scraper n’est pas illégal en soi, mais d’autres lois peuvent s’appliquer.
Conditions d’utilisation et légalité du web scraping
Certaines plateformes interdisent explicitement le Web scraping dans leurs conditions d’utilisation. Cela veut dire que si vous les acceptez et scrapez le site quand même, le webmaster pourrait engager une Action contre vous en invoquant le Computer Fraud and Abuse Act (CFAA).
Cette mise en garde touche un autre sujet déjà abordé. En fait, on accepte les conditions d’utilisation en créant un compte ou en se connectant à un site ou à un service. Si vous pouvez extraire des données sans vous connecter (et sans accepter les conditions d’utilisation en cours de route), vous n’aurez probablement pas de conséquences légales
Comment collecter des données à grande échelle sans enfreindre les règles du web scraping
En gardant à l’esprit tout ce dont on a parlé, vous pouvez scraper des sites web sans enfreindre la loi}, à condition de le faire prudemment. Pour rester du bon côté de la loi, suivez ces cinq conseils :
- Évitez de récupérer des données protégées ou soumises au droit d’auteur.
- Vérifiez les Conditions générales d’utilisation d’un site web avant de le scraper.
- Faites attention en collectant des données soumises au RGPD, à la CCPA ou à d’autres lois similaires.
- Ne submergez pas les serveurs du site de requêtes
- Ne scrapez pas pendant les heures de pointe
Notez que ces conseils s’appliquent surtout si vous utilisez des méthodes de scraping manuelles, comme Python. Vous pouvez éviter bien des tracas en optant pour un outil de scraping performant. Le processus sera alors plus fluide, et vous avez la certitude que la plateforme choisie intègre des mécanismes pour garantir une collecte de données éthique>.
Il existe d’innombrables outils de data scraping sur le web, et le meilleur choix dépendra surtout de vos besoins et objectifs. Si vous cherchez une solution orientée vente qui booste vos Outbound, Clay peut être une excellente option. 🚀
Clay : la façon la plus simple d’obtenir toutes les données Prospect dont vous avez besoin

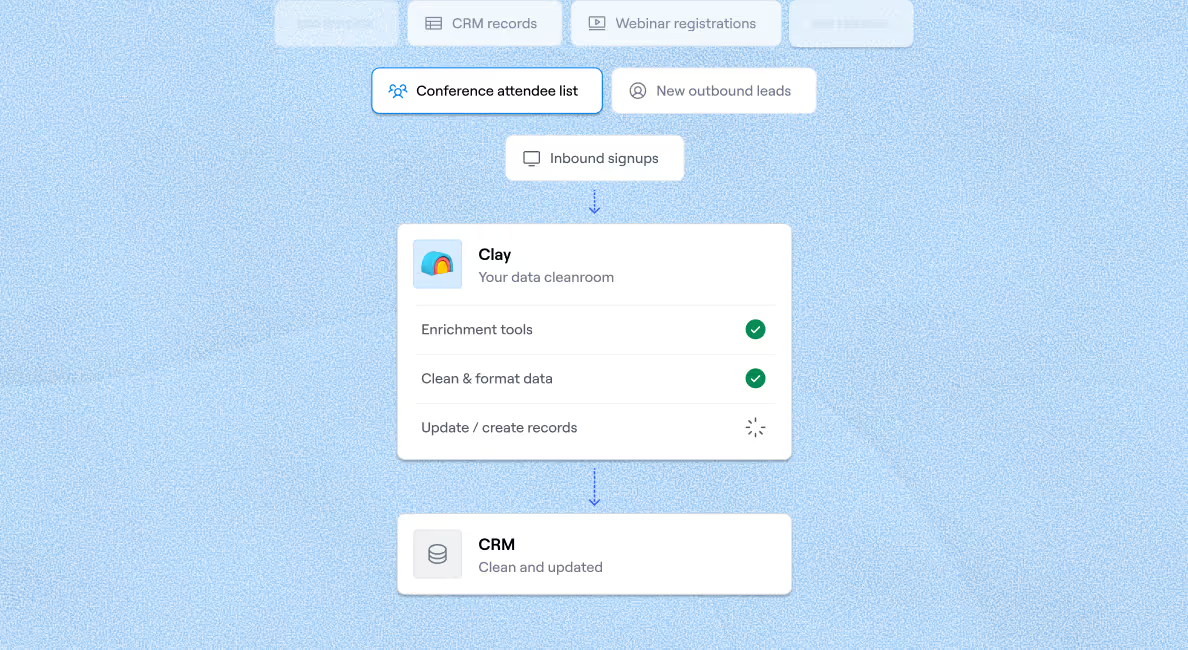
Clay est une plateforme robuste d’enrichissement de données et d’automatisation des ventes remplie de fonctionnalités de web scraping. Si vous débutez dans le scraping et cherchez une solution sans prise de main pour collecter les données de vos prospects, commencez avec Claygent, un AI scraper qui explore le web pour extraire les informations dont vous avez besoin à partir de simples consignes.
Vous pouvez dire à Claygent d’effectuer des tâches spécifiques ou lui poser des questions comme :
- Qui sont les principaux concurrents de [X company] ? ⚔️
- Quel est le prix moyen des produits listés sur [X website] ? 💲
- Qui est le responsable du recrutement pour [X role] ? 🧑💼
Vous obtiendrez des réponses à toutes vos questions en quelques secondes et vous éviterez le processus de scraping manuel. Si vous do souhaitez extraire des sites web spécifiques, utilisez Clay's Extension Chrome. Elle récupère les informations en temps réel pendant que vous parcourez une page, vous permettant d’exporter toutes sortes de données d’un simple clic. Vous pouvez créer des recettes de scraping spécifiques pour différents types de données sans coder ni autre travail chronophage.

Clay propose plus de 100 intégrations, dont beaucoup sont destinées au scraping. Certaines des intégrations les plus utiles sont présentées dans le tableau suivant :
| Intégration | Ce que ça apporte |
|---|---|
| Scraper le site | Nous extrayons les pages à partir des URL que vous indiquez et des données ou mots‑clés que vous choisissez. |
| Extraire les données d’une URL | Utilise l’API ScrapeMagic pour extraire les données des pages que vous avez sélectionnées |
| Récupérer les données de la page | Permet de récupérer des données sur plusieurs sites en même temps grâce à des recettes personnalisées |
Enfin, vous pouvez automatiser le scraping grâce à des dizaines de Clay Template. Vous pouvez réaliser de nombreuses actions, de Enrichir Inbound Leads à scraper les offres d’emploi Indeed, le tout sans configurations complexes.
Boostez vos SDR grâce à l’enrichissement de données et aux fonctionnalités IA de Clay
Web scraping n’est qu’un aspect du large éventail de fonctionnalités de Clay. La plateforme vous permet de concevoir des campagnes d’outreach très efficaces dès le départ, même si vous n’avez encore aucun Lead.
Par exemple, vous pouvez utiliser Clay pour trouver des Lead grâce à de nombreux filtres de recherche, et obtenir une liste abondante en quelques minutes. Vous pouvez ensuite Enrichir Lead avec des données telles que des e‑mails, des numéros de téléphone}, et bien d’autres informations que vous utiliserez pour envoyer des e‑mails hyper‑personnalisés.
Avec Clay, vous avez accès à plus de 50 fournisseurs de données, dont certaines des plus grandes bases de données B2B du marché. Cela garantit une couverture maximale des données, réduisant le risque de rebond de vos e‑mails.

Pas le temps d’écrire des séquences d’emails ? Laissez le AI de Clay s’en charger. Il extrait automatiquement les données de votre table Clay pour écrire des brouillons en quelques secondes. Lorsque les emails sont prêts, vous pouvez les envoyer à votre (outil de) séquençage d’emails sans tracas, grâce aux intégrations de Clay avec les plateformes populaires.
Tarifs flexibles, ROI maximisé
Vous pouvez voir Clay en Action en vous inscrivant à son plan gratuit complet. C’est idéal pour les débutants qui veulent créer leurs premières listes de Lead et se familiariser avec le Web scraping. Si vous voulez accéder à des fonctionnalités plus avancées, vous pouvez passer à l’un des plans payants :
| Plan | Coût |
|---|---|
| Launch | 185 $/mois |
| Growth | 495 $/mois |
| Entreprise | Tarif sur mesure |
Quel que soit le plan que vous choisissez, vous tirerez le meilleur parti de votre investissement grâce à Clay Enrichissement en cascade, une approche innovante de collecte de données qui ne vous fait payer que pour les recherches réussies.
FAQ
Le web scraping, c’est légal ?
Le Web scraping est techniquement légal aux États‑Unis, aucune loi fédérale ne l’interdit explicitement. Mais la légalité dépend de ce que vous collectez, de la façon dont vous y accédez et du respect de réglementations comme le RGPD, la CCPA et les droits d’auteur. Le scraping de données privées reste illégal en toutes circonstances.
Le scraping de contenus protégés par le droit d’auteur, c’est légal ?
Le scraping de contenus protégés n’est autorisé que lorsqu’il relève du fair‑use, par exemple à des fins éducatives, de reportage ou de recherche. Si vous récupérez du contenu protégé pour le reproduire, l’utiliser commercialement ou le diffuser sans autorisation, vous ne pourrez pas invoquer le fair‑use.
Qu’est‑ce que le web scraping ?
Le Web scraping, c’est le processus automatisé d’extraction de données à grande échelle depuis les sites web. On l’utilise pour un large éventail d’usages, de la formation en IA et la recherche académique à la génération de Lead et aux campagnes de Outbound.
Quelles pratiques de scraping sont éthiques ?
Le scraping éthique consiste à se limiter aux données accessibles publiquement, à vérifier les Conditions générales d’utilisation d’un site avant de scraper, à ne pas surcharger les serveurs de requêtes et à respecter les lois sur la confidentialité en vigueur comme le RGPD et le CCPA. Recourir à un outil dédié plutôt qu’à des scripts manuels permet aussi de collecter les données de façon responsable.
Lancez des campagnes data‑driven avec Clay
Si vous voulez faire passer vos campagnes de web scraping et d’Outbound au niveau supérieur, vous pouvez créer un compte Clay gratuit en trois étapes :
- Visitez la page d'inscription 👈
- Entrez votre nom, votre e‑mail et votre mot de passe
- Explorez les fonctionnalités de Clay
Pour en savoir plus sur la plateforme et ses fonctionnalités, n’hésitez pas à parcourir Clay's University et à rejoindre la communauté Slack community de professionnels du marketing et des ventes en pleine expansion. Vous pouvez aussi sign up for Clay's newsletter pour recevoir des astuces et des mises à jour utiles afin d’envoyer des e‑mails qui captivent et convertissent vos Prospects sans effort.