



















Bien que de nombreux outils offrent des fonctionnalités comme le solveur CAPTCHA et la rotation d’IP pour extraire des données sur des sites qui interdisent data scraping, il n’est pas recommandé de les utiliser. En vous inscrivant sur n’importe quel site, vous acceptez ses Conditions générales d’utilisation et ses politiques ; les enfreindre peut entraîner un bannissement, voire des poursuites judiciaires.
Pour vous aider à collecter des données de façon éthique, ce guide vous montrera comment identifier les sites qui autorisent le web scraping. Vous y trouverez aussi des exemples de sites pro‑scraping éprouvés, ainsi qu’une recommandation pour un outil de web scraping}.
En bref :
- Vous pouvez vérifier si un site web autorise le scraping en consultant son fichier robots.txt, ses en‑têtes HTTP, ses **Conditions générales d’utilisation** et toute mention d’une initiative Open Data.
- Beaucoup de sites – finance, sport, météo, bases de données publiques, offres d’emploi et voyages – autorisent le scraping ou proposent des API officielles.
- Les données publiques sont généralement sûres à collecter. Les informations personnelles identifiables (PII) sont soumises aux restrictions du RGPD et du CCPA, et les données protégées par le droit d’auteur nécessitent une autorisation explicite.
- Des outils comme Clay combinent le Web scraping avec un enrichissement en cascade auprès de plus de 150 fournisseurs de données, vous permettant d’extraire, d’enrichir et d’utiliser les données en un seul flux de travail.
Pourquoi les sites web autorisent-ils le web scraping ?
Bien que certains sites web et plateformes interdisent le scraping pour protéger la vie privée de leurs utilisateurs, l’extraction de données publiques reste légale, tant que cela respecte les lois et réglementations du pays concerné. Heureusement, de nombreux sites autorisent le scraping à leur avantage, notamment :
- 🚀 Trafic accru: les données extraites peuvent atteindre de nouvelles Audience et les Lead vers le site original pour plus de détails
- 🔄 Partage de données : Les sites qui adoptent l’open data autorisent le scraping et invitent chacun à exploiter leurs données sans restriction
- ⚖️ Contrôle et régulation: Les sites web qui autorisent le Web scraping via une API peuvent contrôler le volume et la fréquence des requêtes et n’autoriser l’accès qu’aux utilisateurs autorisés.
- 🤝 Développement communautaire : Le scraping éthique peut fédérer une communauté autour du site, où chacun partage conseils, guides et crée même des outils pour l’améliorer.
6 façons d’identifier les sites qui autorisent le web scraping

Pour vous assurer que votre scraping de données reste éthique, suivez ces étapes pour vérifier la position de chaque plateforme concernant le scraping de données :
- Vérifiez le fichier robots.txt
- Recherchez une API officielle de scraping
- Consultez les Conditions générales d’utilisation
- Inspectez les en‑têtes HTTP
- Évaluez les données du site
- Consultez les initiatives Open Data
1. Lire le fichier Robots.txt
Un fichier robots.txt se trouve à la racine d’un site web et indique aux scrapers s’ils peuvent extraire des données et quelles pages ils peuvent consulter.
Vous pouvez accéder au fichier en ajoutantrobots.txt à la fin du domaine du site que vous souhaitez scraper. Par exemple :
Si un site n’a pas de fichier robots.txt ou n’a pas indiqué le contraire, il peut autoriser implicitement le scraping de fichiers. Cela dit, pour être sûr, prenez en compte les autres indicateurs présentés dans ce guide.
Cela dit, les web scrapers n’ont pas l’obligation de respecter le fichier robots.txt, mais cela vous donne une idée de la position du site sur le scraping.
2. Cherchez une API de scraping
Certains sites web qui autorisent le web scraping offrent une API de scraping officielle que les utilisateurs peuvent intégrer. Voici quelques solutions populaires :
En proposant une API de scraping, le site peut réguler le volume et la fréquence des requêtes pour ne pas surcharger ses serveurs. Cela renforce aussi la Sécurité des données grâce au chiffrement et aux contrôles d’accès, garantit leur intégrité en les livrant dans des formats fiables, et élimine les erreurs typiques des webscrapers. 💻
Pour savoir si un site propose une API de scraping :
- Recherchez dans sa documentation des sections comme API and Developers
- Google [nom du site web] API
- Consultez le pied de page ou le plan du site
3. Consultez les Conditions générales d’utilisation
Les sites qui autorisent le Web scraping peuvent l’indiquer explicitement dans leurs conditions d’utilisation, ainsi que des directives sur la façon de récupérer et d’utiliser les données de manière responsable.
Vous pouvez vérifier en ouvrant la page des Conditions générales d’utilisation et en cherchant des termes comme scraping, utilisation des données, et crawling. Si quelque chose n’est pas clair, contactez l’équipe support pour en discuter. 🗣️
4. Inspectez les en-têtes HTTP
Certains sites web définissent l’en‑tête HTTP X‑Robots‑Tag pour contrôler le comportement des scrapers de façon plus précise que le fichier robots.txt. Conçu d’abord pour guider les moteurs de recherche, il fonctionne aussi avec les scrapers.
Comme le fichier robots.txt, le X‑Robots‑Tag ne bloque pas l’accès aux ressources du site. Son efficacité dépend du respect des directives par les scrapers. Pourtant, cet en‑tête vous aide à comprendre la position d’un site face au Web scraping.
Vérifiez l’en‑tête HTTP d’un site web avec les outils développeur de votre navigateur :
- Chargez l’URL dans Chrome et ouvrez les outils de développement en appuyant sur Ctrl+Shift+I ou en faisant un clic droit sur la page et en sélectionnant Inspect
- Cliquez sur l’onglet Network
- Rechargez la page et cliquez sur le fichier à gauche du panneau
- Regardez le côté droit du panneau pour les informations d’en‑tête HTTP
Vous pouvez aussi tester en installant le Web Developer plugin ou l’extension Robots Exclusion Checker sur Chrome, ou en écrivant un petit script Python. ⌨️
5. Évaluez le type de données du site
Il existe trois types de données de site web : publiques, personnelles et protégées par le droit d’auteur. Voici à quoi chacune peut ressembler :
| Données publiques | Données personnelles | Données sous copyright |
|---|---|---|
| Articles de presse publics | Noms | Articles |
| Pages Wikipédia | Adresses | Vidéos |
| Publications sur les réseaux sociaux | Dates de naissance | Images |
| Profils publics | Données biométriques | Musique |
| Fiches produits sur les plateformes e‑commerce | Numéros de téléphone | Bases de données |
Dans le contexte du scraping, les données publiques sont les informations accessibles sans connexion. Un site qui propose ce type d’informations est généralement exploitable, sauf s’il l’interdit explicitement dans son fichier robots.txt, ses en‑têtes HTTP ou ses conditions d’utilisation.
En revanche, il n’existe aucune directive universelle pour le scraping d’informations personnellement identifiables (PII). Chaque juridiction a ses propres règles. Les deux plus connues sont le General Data Protection Regulation (GDPR) et le California Consumer Privacy Act (CCPA), qui interdisent la collecte, le stockage et l’usage des PPI sans raison légale et sans le consentement explicite du propriétaire.
Les sites web contenant des données protégées peuvent interdire le scraping selon votre usage prévu. Les données protégées par le droit d’auteur appartiennent à des particuliers ou des entreprises} avec un contrôle explicite sur leur collecte et leur reproduction. 📁
💡 Lecture bonus : Découvrez ces articles qui offrent des solutions pour le scraping :
6. Recherchez les initiatives d’open data
Certains sites participent aux initiatives d’Open Data et offrent un accès gratuit à des jeux de données que tout le monde peut utiliser et redistribuer. Ils indiquent clairement les autorisations de scraping et d’exportation dans leurs conditions d’utilisation.
Pour vérifier si un site web adopte l’esprit des données ouvertes, recherchez les mentions du Open Data sur la page À propos.
💡 Astuce : Si les six méthodes ci‑dessus ne suffisent pas à éclaircir la position du site, contactez l’administrateur ou le propriétaire pour obtenir l’autorisation ou des précisions sur les méthodes ou canaux de collecte de données approuvés.
Quels sites autorisent le web scraping ?

Vous trouverez ci-dessous des recommandations de sites à exploiter pour extraire des données, classées dans les catégories suivantes :
- Finance
- Sports
- Météo
- Bases de données publiques
- Sites d’offres d’emploi
- Voyage et hôtellerie
Finance 💲
Les sites qui offrent des infos et des outils financiers – données de marché en temps réel ou historiques, actualités – autorisent souvent le scraping. Exemples :
Sports ⚽
Les sites sportifs qui offrent une couverture complète permettent aux fans, aux analystes et aux chercheurs de récupérer des données comme les classements de ligues et les statistiques de performance des joueurs et des équipes. Exemples :
Météo ☔
Les sites météo offrent des données – prévisions et conditions actuelles – utiles dans de nombreux secteurs : sport, mines, agriculture, construction, etc. Exemple :
Bases de données publiques 📂🌐
Les bases de données publiques contiennent des données sur la criminalité, la santé, l’emploi, la réglementation, la démographie et d’autres documents publics, que l’on peut extraire, réutiliser et redistribuer sans aucune restriction. Exemples :
Sites d’emploi 👷
Les sites d’offres d’emploi permettent le web scraping de données comme les intitulés de poste, les descriptions et les noms d’entreprise. Par exemple :
Voyage et hôtellerie ✈️
Les sites de voyage et d’hôtellerie peuvent autoriser le scraping des prix, des vols, des hôtels et des destinations pour faciliter la planification et la réservation. Exemples :
Bonnes pratiques pour le Web scraping des sites qui autorisent le scraping
Une fois le site identifié, suivez ces conseils pour extraire les données efficacement tout en respectant les ressources du site.
| Astuce | Explication |
|---|---|
| ⌛ Ne surchargez pas le serveur | Évitez d’envoyer trop de requêtes d’un coup : insérez un délai entre chaque appel ou planifiez votre scraping en dehors des heures de pointe. Ainsi, vous ne perturberez pas le fonctionnement normal du site. |
| ⚒️ Utilisez les API du site | Une API officielle vous permet de scraper en toute sécurité et vous assure de ne collecter que des données publiques. |
| 📝 Restez éthique | Même si vous n'êtes pas tenu·e de suivre les instructions, respectez le fichier robots.txt, l’en‑tête HTTP et les conditions d’utilisation. |
| 🗺️ Consultez le plan du site | Le plan du site répertorie les types de fichiers du site ; le suivre simplifie votre projet de web scraping. |
| ©️ Ne violez pas le droit d’auteur | Ne récupérez pas de données protégées sans autorisation explicite ou sans invoquer le fair‑use. |
| ⚖️ Respectez le RGPD et la CCPA | Ne récupérez pas les données personnelles des citoyens de l’UE ou de la Californie sans leur autorisation explicite ou une raison légale. |
Comment extraire des données de haute qualité sur des sites qui autorisent le web scraping
Même si on peut extraire les données à la main, les projets à grande échelle ont besoin d’un web data scraper car c’est plus pratique que d’ouvrir chaque page et de copier‑coller les infos dont vous avez besoin. Avec un scraper robuste, vous extrayez rapidement et efficacement des données de haute qualité sur des milliers, voire des millions, de pages.
Cela dit, tous les outils ne se valent pas, alors choisissez‑en un qui coche les cases suivantes :
- ✔️ Simple à utiliser
- ✔️ Offre des fonctions d’automatisation et de planification
- ✔️ Exportez les résultats sous plusieurs formes et formats de fichiers
- ✔️ Peut gérer tous les types de sites web, y compris les sites complexes aux éléments dynamiques
Pour réduire les coûts, cherchez un extracteur de données avec des fonctions d’enrichissement afin de collecter et consolider les données provenant de plusieurs sources, et de garantir que vos résultats soient précis, à jour et pertinents. Une solution centralisée comme celle‑ci vous fait gagner du temps, de l’argent et des ressources humaines. 💸
Si vous cherchez un outil pour extraire, formater et enrichir des données de haute qualité de façon fiable, Clay est la solution. Il puise dans plus de 50 bases de données pour vous fournir les informations dont vous avez besoin, comme détaillé ci‑dessous. 👇
Comment Clay peut vous aider à extraire des données de haute qualité
Clay est une plateforme complète data providing and Enrichissement platform dotée de capacités de scraping robustes. Elle propose deux fonctionnalités natives et automatisées qui vous permettent de collecter des données depuis le web :
- Assistant IA de scraping
- Extension Chrome
Claygent est un extracteur de données IA qui vous permet de scraper des sites web via des invites. Il suffit de dire à l’assistant quels points de données vous recherchez et où les trouver. Claygent trouve et organise les résultats en quelques secondes.
Vous pouvez l’utiliser pour obtenir des détails sur personnes et entreprises sans lever le petit doigt, ce qui en fait le scraper idéal si vous débutez ou si vous cherchez une solution automatisée pour extraire des données. 💪

Si vous voulez scraper des données pendant que vous naviguez, utilisez l’extension Extension Chrome de Clay. Elle collecte automatiquement les informations dès l’ouverture d’une page. Vous pouvez aussi créer des recettes personnalisées de collecte de données pour répondre à vos besoins spécifiques, sans coder. 🖱️
Bien que ce soit impressionnant, le web scraping n’est que la partie visible de ce que Clay peut faire. La plateforme propose plein d’outils d’enrichissement de données pour combler les éventuels manques.
Optimisez la couverture des données avec Clay
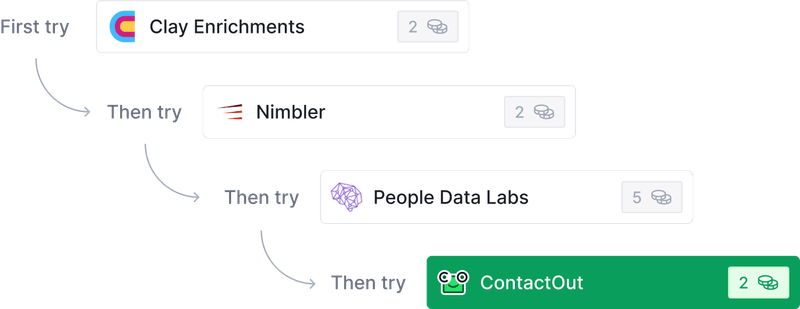
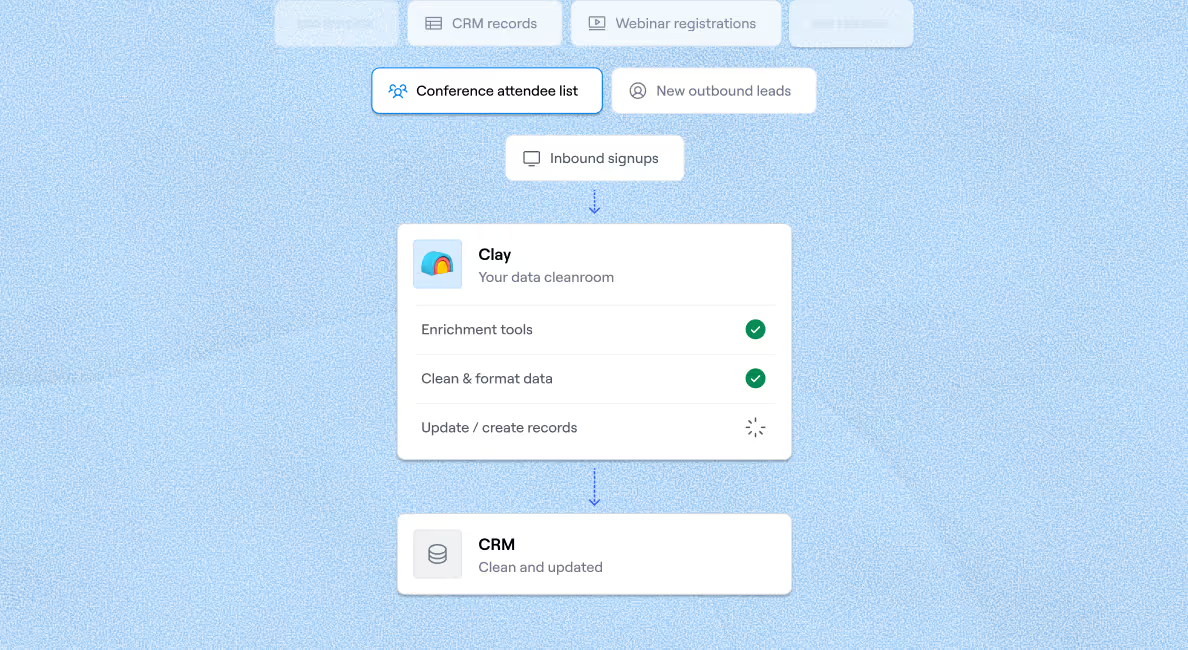
Après le scraping, exploitez les fonctionnalités d’enrichissement de données de pointe de Clay pour améliorer la qualité de vos résultats. Contrairement aux scrapers web classiques, Clay s’intègre à des dizaines de fournisseurs de données, vous bénéficiant d’une couverture et d’une fiabilité inégalées.
Pour enrichir vos résultats, Clay vous laisse choisir les fournisseurs de données à exploiter et utilise Enrichissement en cascade pour vérifier chaque base, une à une, jusqu’à ce que l’information recherchée apparaisse. Vous ne payez que pour les données réellement trouvées, ce qui évite les dépassements de budget. 💵
Après avoir Enrichir vos données, vous pouvez les pousser vers votre CRM, les exporter en fichier CSV, ou, si vous lancez une campagne Outbound, utiliser le AI email drafter pour créer des e‑mails hyper‑personnalisés pour chaque Lead. 📧

Trouvez les possibilités infinies de Clay
Les fonctionnalités impressionnantes de scraping et d’enrichissement ne sont que le début. Clay propose plus de 100 intégrations, dont beaucoup peuvent simplifier le processus d’extraction des données. Le tableau ci‑dessous en présente quelques‑unes :
| Intégration | Fonction |
|---|---|
| ⭐ Extraire les données d’une URL | Utilisez l’API ScrapeMagic pour extraire les données d’une page web. |
| ⭐ Trouver des avis d’entreprise | Entrez le nom, le site ou l’adresse d’une entreprise et obtenez sa note Google, le nombre d’avis et d’autres informations. |
| ⭐ Trouver des mots‑clés sur le site | Vérifie un site web précis à la recherche de mots‑clés ou d’expressions ciblées |
| ⭐ Obtenez les produits | Extrait la liste des produits et leurs détails depuis l’URL d’une boutique Shopify |
La plateforme propose également Template qui sont livrés avec des Clay Tables préassemblées et des automatisations> pour vous aider à effectuer diverses tâches de scraping , telles que :
- Scraping Google Maps
- Collecte d'offres d'emploi Indeed
- Enrichir inbound Lead
- Déterminer le nombre de postes et d’employés ouverts dans une entreprise 🔍
Beaucoup de personnes, ainsi que des pros du marketing et des ventes qui ont testé Clay, en sont bluffés. Voici ce qu’un d’eux a déclaré à son sujet :

Créez votre compte Clay
Vous pouvez explorer les fonctionnalités de Clay en trois étapes rapides :
- Allez à la page d’inscription 👈
- Indiquez votre nom et votre adresse e‑mail
- Exploitez les fonctionnalités de la plateforme
Clay propose un plan gratuit à vie qui vous permet de tester la plateforme. Si cela vous séduit, choisissez l’un des quatre forfaits payants présentés dans le tableau ci‑dessous :
| Plan | Nombre de Crédits data | Tarif |
|---|---|---|
| Launch | 2 500 à 10 000 /mois | 185 $/mois |
| Growth | 6 000 à 100 000 par mois | 495 $/mois |
| Entreprise | Personnalisé | Personnalisé |
Si vous voulez en savoir plus sur la plateforme et ce qu’elle peut faire, consultez Clay University et rejoignez la communauté Slack. Pour rester informé des dernières astuces et fonctionnalités, inscrivez‑vous à la newsletter de Clay. 💌
FAQ
Le web scraping, c’est légal ?
Le scraping de données publiques est généralement légal, à condition de respecter les lois locales. En revanche, extraire des informations personnelles identifiables sans consentement peut contrevenir au RGPD ou au CCPA, et récupérer du contenu protégé par le droit d’auteur sans autorisation expose à des risques juridiques. Vérifiez toujours les Conditions générales d’utilisation d’un site avant de scraper.
Comment savoir si un site autorise le web scraping ?
Vérifiez le fichier robots.txt du site, relisez ses Conditions générales d’utilisation pour repérer d’éventuelles mentions de scraping ou d’exploration, examinez les en‑têtes HTTP à la recherche de directives X‑Robots‑Tag, et cherchez une API officielle. Si le site s’inscrit dans des initiatives Open Data, il le mentionnera généralement sur sa page À propos. En cas de doute, contactez directement le propriétaire du site.
Quelle est la différence entre le scraping de données publiques et celui de données personnelles ?
Les données publiques sont des informations accessibles sans connexion : articles de presse, profils publics, fiches produit. En général, on peut les extraire, sauf interdiction explicite. Les données personnelles regroupent noms, adresses, numéros de téléphone et données biométriques. Le scraping de ces informations est encadré par le RGPD et le CCPA ; il faut une base légale et le consentement explicite de la personne concernée.
Quels types de sites web permettent le plus souvent le Web scraping ?
Les sites financiers comme Yahoo Finance et Google Finance, les sites de référence sportive, les plateformes météo, les bases de données publiques gouvernementales, les sites d’offres d’emploi et les sites de réservation de voyages figurent parmi les catégories les plus courantes autorisant le scraping. Beaucoup proposent des API officielles qui simplifient l’accès aux données structurées.
📚 Poursuivez votre lecture : Pour découvrir davantage, explorez ces articles sur le scraping des réseaux sociaux :