


















Les données guident chaque décision, de l’achat de nouvelles photocopieuses à la création de stratégies marketing efficaces.
Bien sûr, vous pouvez collecter les données manuellement en parcourant de nombreux sites et en extrayant les informations. Sinon, apprenez le scraping de données pour gagner du temps, réduire les coûts, améliorer la précision et automatiser le travail.
Dans ce guide, nous couvrirons :
- Ce qu’il faut savoir sur le scraping
- La méthode la plus efficace pour accéder à des infos fiables et utiles 📚
En bref :
- Le scraping de données consiste à extraire automatiquement des informations de sites web et à les stocker dans un tableau ou un fichier pour les analyser.
- On utilise souvent la génération de Lead, les études de marché, la veille concurrentielle et l’analyse du sentiment client.
- Il existe sept techniques principales, du copier‑coller manuel aux scrapers web alimentés par l’IA. Les outils no‑code sont l’option la plus accessible pour les personnes qui ne codent pas.
- Le scraping de données publiques est généralement légal, mais vous devez respecter les Conditions générales d’utilisation de chaque site ainsi que la réglementation locale.
Qu’est‑ce que le scraping de données ?
Le scraping de données consiste à extraire des informations de diverses sources internet et à les importer dans un tableau ou un fichier pour des usages tels que :
- Analyser vos concurrents
- Créer des listes de Lead
- Collecter l’intelligence économique
- Comparer les prix
Ce processus n’est généralement pas réalisé par des humains, mais par des outils spécialisés appelés data scrapers qui pêchent et récupèrent les données dont vous avez besoin. 🎣
Les sources de données peuvent être des sites web, des boutiques en ligne, des pages d’entreprise ou des réseaux sociaux. En bref, les outils de scraping vous permettent d’extraire les informations de n’importe quel coin du web et de les regrouper dans un seul fichier ou tableau, prêts à être analysés et exploités.

Comment le scraping de données fonctionne ?
Une tâche de scraping utilise un code créé pour récupérer les points de données requis} sur un site web. Vous pouvez écrire le code vous‑même si vous avez les compétences, mais ce n’est pas obligatoire. De nombreux extracteurs de données sont fournis avec du code prêt à l’emploi}, donc vous n’avez pas à vous soucier de l’aspect technique du scraping. 🧑💻
Quoi qu'il en soit, le code se connecte à la source et envoie des requêtes pour récupérer les infos nécessaires. Ensuite, il filtre les réponses pour ne garder que les données qui correspondent à vos critères.
Cas d’usage courants du scraping de données
Passons en revue les scénarios les plus populaires où le scraping de données occupe le rôle principal :
- Lead génération
- Étude de marché
- Analyse des concurrents
- Analyse du sentiment client
Lead Generation
Si vous êtes orienté·e vente et que vous voulez élargir votre clientèle, le scraping de données devient votre meilleur allié. En extrayant des informations sur différents sites et plateformes, vous repérez les personnes et les entreprises qui correspondent à votre profil client idéal, puis vous concentrez vos efforts sur elles.
Identifier les personnes et les entreprises qui sont susceptibles d’acheter chez vous vous fait gagner beaucoup de temps, car vous savez sur qui vous concentrer. Cela vous fait aussi économiser des ressources. Vous n’avez pas besoin d’autant de commerciaux. 😎
Par exemple, vous pouvez scraper des données de profils sur les réseaux sociaux pour générer des Lead. Avec le bon outil, vous pouvez filtrer votre recherche et extraire les données des profils qui correspondent à vos critères, comme :
- Lieu
- Expérience
- Taille de l’entreprise
💡 Tu savais ? Clay peut t’aider à construire des listes de Lead parfaites où que tu sois sur Internet.🥰
Recherche de marché
Le scraping de données est utile quand vous lancez une nouvelle entreprise ou un nouveau produit et que vous voulez tester le marché. 🌊
Le processus peut mettre en lumière les dernières tendances du secteur ainsi que les préférences et comportements des clients, vous permettant d’ajuster rapidement votre approche et de garder une longueur d’avance.
Extraire des données pour étudier le marché est utile à toutes les entreprises, pas seulement à celles qui traversent de grands changements. En analysant le marché régulièrement, vous ne laissez rien d’important vous échapper. Avec les bonnes données en main, vous pouvez même anticiper les tendances et repérer les manques du marché, et les transformer en une vraie opportunité de croissance. 📈
Analyse concurrentielle
Surveiller ses concurrents, c’est judicieux pour plusieurs raisons :
- Vous pouvez analyser leur offre et ajuster votre stratégie en conséquence ✔️
- Cela vous aide à identifier leurs forces et leurs faiblesses ✔️
- Ça vous aide à identifier vos points forts uniques ✔️
- C’est une belle opportunité d’apprentissage ✔️
Extraire des données est l’un des moyens les plus simples d’analyser vos concurrents. Plutôt que de passer des jours à rassembler des infos, vous accédez à des données complètes en quelques clics.
Analyse du sentiment client
Grâce à l’analyse du sentiment client, vous mesurez les attitudes, les émotions, les comportements et les préférences de vos clients. Ces insights orientent vos décisions, le positionnement de vos produits et vos stratégies marketing.
En extrait des données de sites web, vous pouvez effectuer une analyse approfondie du sentiment client et rendre le processus rapide et facile.
Par exemple, vous pouvez extraire les commentaires et les notes des principales plateformes d’avis comme G2 et Capterta pour voir ce que les utilisateurs pensent d’une appli ou d’un site. Vous obtiendrez ainsi une vision claire du sentiment client et pourrez transformer ces données en décisions éclairées pour faire avancer votre entreprise. 🧭
Légalité du scraping de données

Pour certains, le scraping de données peut sembler douteux ou éthiquement discutable. Après tout, vous utilisez les informations de quelqu’un d’autre et vous vous demandez si cela peut vous mettre dans l’illégalité. ❓
De par sa nature, le scraping de données est tout à fait légal, mais il faut garder à l’esprit quelques points essentiels lorsqu’on extrait des informations de sites web.
Tout d’abord, distinguons entre données publiques et privées dans le contexte du scraping de données. Les données publiques sont celles que vous pouvez consulter sans créer de Compte ni fournir d’identifiants de connexion spécifiques, notamment :
- Offres et tarifs des boutiques en ligne
- Annonces immobilières
- Recherche académique publique
Le scraping de ces données est légal, tant que vous respectez les lois en vigueur. Par contre, extraire des données protégées par le droit d’auteur ou privées sans autorisation peut entraîner des soucis juridiques.
Un autre point à prendre en compte, c’est où vous voulez extraire des données. Chaque site a ses propres règles, appelées Conditions générales d’utilisation. Si un site interdit le scraping et que vous le faites quand même, vous risquez des problèmes juridiques.
Il faut aussi savoir que chaque pays et chaque État peuvent avoir une interprétation différente de la légalité du scraping de données. Vérifiez bien les règles et réglementations pour éviter tout problème juridique. ⚖️
Techniques d'extraction de données
Bien que les techniques de scraping de données partagent le même objectif, elles proposent des chemins différents pour atteindre la ligne d’arrivée. 🏁
Passons en revue les techniques de scraping de données les plus populaires et leurs caractéristiques :
- Copie‑collage manuel
- Analyse du HTML
- Analyse du DOM
- Regroupement vertical
- XPath
- Reconnaissance optique de caractères
- Collecteurs de données web
Copie et collage manuels
Le copier‑coller est la forme la plus simple et la plus traditionnelle de collecte de données. La technique est directe et accessible aux débutants : aucune application ou outil n’est requis. Il suffit de :
- Visitez le site contenant les données que vous souhaitez extraire
- Copiez les données
- Collez‑le dans une feuille de calcul ou un fichier
Le problème ? Copier‑coller les données à la main ne fonctionne pas quand on scrape à grande échelle.
Imaginez devoir parcourir des centaines de sites, copier‑coller les données, les trier, puis les analyser. Au final, vos données seront déjà périmées et vous recommencerez tout le processus. ⌛
Analyse du HTML
Cette technique se concentre sur l’analyse du code HTML d’un site que vous voulez scraper. Une fois l’analyse terminée, le parseur extrait les données pertinentes et vous les remet pour les exploiter ou les étudier.
Le choix du bon analyseur dépend de plusieurs critères, dont :
- Le langage de programmation que vous utilisez pour extraire des données
- Le type de site que vous souhaitez extraire
- Votre niveau de codage
Cette technique offre des atouts, comme une grande personnalisation et une compatibilité impressionnante. Mais le négatif l’emporte souvent : certains analyseurs ne supportent pas le contenu dynamique, ce qui limite leur efficacité. En plus, de nombreux analyseurs sont gourmands en ressources, ce qui ralentit les performances.
Il faut aussi savoir que mettre en place des parseurs demande souvent des compétences en programmation. Si vous n'êtes pas à l'aise avec le code, mieux vaut chercher une autre solution. 🏊

Analyse du DOM
L’analyse DOM est étroitement liée à l’analyse HTML. Dans les deux cas, vous récupérez le code HTML d’une page web. La différence ? L’analyse DOM vous permet de créer une représentation du modèle d’objet Document (DOM) (arbre) du HTML que vous pouvez ensuite manipuler pour extraire les données qui vous intéressent.
Alors que l’analyse DOM vous donne une vue d’ensemble de haut niveau de la structure de la page web que vous souhaitez extraire et permet une extraction ciblée, ce n’est pas la meilleure option pour un scraping à grande échelle.
Regroupement vertical
Les entreprises peuvent extraire des données en créant leurs propres plateformes d’agrégation verticale, équipées de bots dédiés à chaque secteur. Cette technique vous permet de scraper plusieurs sites traitant du même sujet, ce qui est idéal pour la Surveillance en cours de la concurrence ou analyser les tendances du marché.
Comme il demande peu d’intervention humaine, il convient aux entreprises qui souhaitent automatiser le scraping ou lancer des projets de scraping à grande échelle.
Le problème, c’est que l’agrégation verticale est complexe à mettre en place et à gérer. Vous avez besoin de bien plus que des bases en codage. 🤓
XPath
XPath, abréviation de XML Path Language, est un langage qui identifie et parcourt les documents XML, y compris le HTML. Il vous permet de naviguer facilement parmi les éléments et de sélectionner ceux que vous voulez extraire.
XPath offre des performances impressionnantes, il peut même gérer les pages web les plus complexes, et vous permet de cibler votre scraping.
Cela dit, il faut maîtriser les structures HTML. Si ce n’est pas le cas, engagez quelqu’un qui les connaît ou choisissez une autre méthode de scraping.
Reconnaissance optique de caractères
La reconnaissance optique des caractères (ou OCR) vous permet d’extraire du texte à partir d’images ou de documents numérisés. La technologie sous‑jacent « lit » l’image ou le document et renvoie le résultat sous forme de texte.
L’OCR vous évite la saisie manuelle et est très efficace, mais il a des performances irrégulières. Il ne lit pas toujours les polices atypiques et a du mal avec les images de mauvaise qualité. 🖼️

Extracteurs web
Web scrapers sont des plateformes uniques qui simplifient l’extraction de données sur les sites web. Vous trouverez en ligne de nombreux web scrapers, tels que :
Beaucoup d’utilisateurs les choisissent parce qu’ils sont pratiques. Les scrapers ne demandent pas de compétences en codage, donc tout le monde peut profiter de leurs fonctionnalités sans formation poussée.
Un autre avantage des nombreux web scrapers, c’est qu’ils offrent des fonctionnalités supplémentaires, ce qui vous permet d’unifier votre travail et de simplifier vos processus.
Les scrapers web avancés proposent aussi des solutions pour surmonter les défis courants du scraping :
- CAPTCHA
- Pièges de pot de miel
- Blocages d'IP
Comment choisir votre scraper web
Vous trouverez des dizaines de scrapers web en ligne, et cette variété rend le choix de l’outil idéal difficile. Voici quelques points à considérer lors de la sélection du meilleur outil pour extraire des données de sites web :
| Facteur | Pourquoi c’est important |
|---|---|
| 🧘 Simplicité d’utilisation | L’outil idéal ne doit pas imposer une courbe d’apprentissage raide, ni exiger des mois de formation ou la lecture d’une documentation exhaustive. |
| 💲 Tarif | Idéalement, l’outil choisi doit proposer un plan gratuit à vie}, pour que vous puissiez explorer ses fonctionnalités à votre rythme. Il doit aussi offrir des options tarifaires flexibles}, afin de ne payer que ce que vous utilisez. |
| 🧰 Fonctionnalités additionnelles | Cherchez un outil qui va au-delà du scraping et propose d’autres options dont vous et votre équipe pouvez profiter. Par exemple, si vous travaillez dans la vente, trouvez une plateforme qui offre des fonctionnalités pour managing outbound campaigns ou la personnalisation des e‑mails. |
| 💬 Avis et retours des utilisateurs | La plateforme idéale doit présenter des avis et témoignages d’utilisateurs enthousiastes qui confirment son fonctionnement et ses performances. |
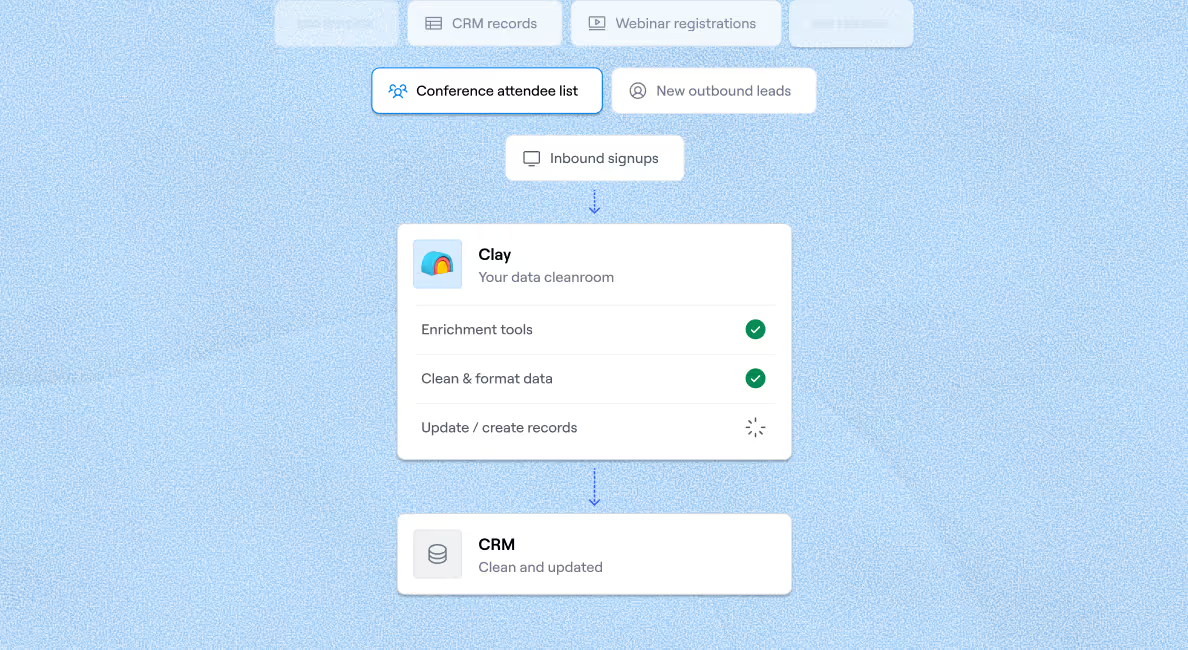
Si vous êtes à la recherche d’une plateforme orientée ventes qui offre d’excellentes fonctionnalités de collecte de données et vous permet de gérer vos Outbound du début à la fin, essayez Clay. Les fonctionnalités de la plateforme vous font gagner du temps et de l’argent tout en boostant vos performances. 🚀
Comment Clay s’inscrit‑il dans le paysage du data scraping ?

Clay est une plateforme d’automatisation des ventes avec des options axées sur les domaines suivants :
- ⭐ Prospect et enrichissement des données
- ⭐ Lead génération
- ⭐ Hyper‑personnalisation de la campagne
En matière de scraping de données, Clay propose plusieurs options de pointe qui vous permettent de extraire toutes sortes de données de n’importe quel site web. La plateforme dispose d’une extension Extension Chrome pratique qui rend le scraping aussi simple que un-deux-trois :
- Vous installez l’extension
- Visitez le site que vous souhaitez scraper
- Lancez l’extension
Et voilà. Clay extrait les données et les organise dans un tableau. 💥
Par exemple, vous pouvez utiliser l’Extension Chrome pour extraire le Web, trouver toutes sortes de people et company data, puis créer des listes de Lead complètes.
Ce n’est que la partie émergée de l’iceberg. Meet Claygent: un scraper web IA.
Claygent élimine la recherche manuelle du scraping. Il vous suffit de dire à Claygent quelles données vous cherchez, et il fouillera le Web pour les trouver pendant que vous vous détendez. ☕
Clay propose également plusieurs Web scraping Template qui peuvent accélérer des tâches de scraping spécifiques. Par exemple :
- Trouver des entreprises locales et leurs coordonnées via Google Maps
- Scraper Indeed pour récupérer les adresses d’entreprise et rédiger des e‑mails personnalisés
- Déterminez le nombre de postes ouverts et d’employés depuis l’URL d’une entreprise
La plateforme intègre plus de 100 applications et outils, dont beaucoup sont conçus pour simplifier le processus de scraping. Voici quelques exemples:
| Intégration | Ce que ça apporte |
|---|---|
| 🌐 Scraper le site web | Simplifie la collecte de données précises sur plusieurs sites web |
| 📄 Récupérer les données de la page | Vous permet d’extraire des données de plusieurs pages d’un site web |
| 🗝️ Trouver des mots‑clés sur le site | Vous pouvez vérifier un site web précis à la recherche de mots‑clés ou d’expressions. |
Passez au-delà du scraping de données avec Clay
Les excellentes options de collecte de données ne sont que le début de l’histoire de Clay. Voici un aperçu des autres fonctionnalités que vous offre la plateforme :
- plus de 50 fournisseurs de données: Au lieu de se brancher sur une seule base de données comme le font de nombreux scrapers, Clay accède à plus de 50 sources pour offrir une couverture et une fiabilité des données exceptionnelles.
- Enrichissement en cascade: Clay recherche séquentiellement parmi les fournisseurs de données pour dénicher les données voulues, réduire les coûts et offrir une flexibilité maximale
- enrichissement IA: Utilisez ChatGPT pour résumer la recherche et faire des interférences. Entraînez l’IA dans Clay pour obtenir de meilleurs résultats
- Personnalisation des e‑mails : comptez sur les données collectées pour créer des e‑mails hyper‑personnalisés qui impressionnent vos Lead
Des centaines d’utilisateurs ont testé ces fonctions et sont séduits par les possibilités de Clay. Découvrez ce qu’un des nombreux utilisateurs satisfaits dit de la plateforme :

Créez votre compte Clay
Créer un compte Clay ne vous prendra pas beaucoup de temps :
- Allez à la page d’inscription 👈
- Fournissez votre nom, votre e‑mail et votre mot de passe
- Explorez les fonctionnalités de Clay
Clay propose un forfait gratuit à vie, idéal pour ceux qui découvrent la plateforme pour la première fois. Le forfait inclut des utilisateurs illimités, ainsi toute votre équipe peut en profiter. Si cela vous séduit, vous pouvez choisir l’un des forfaits payants, selon le nombre de Crédits data dont vous avez besoin.
| Plan | Crédits data | Prix |
|---|---|---|
| 🚀 Démarrage | 2 500 à 10 000 /mois | 185 $/mois |
| 📈 Croissance | 6 000 à 100 000 par mois | $495/mois |
| 💈 Entreprise | Personnalisé | Personnalisé |
Comme pour le plan gratuit à vie, tous les forfaits payants offrent des utilisateurs illimités. Vous n’aurez donc pas à vous inquiéter de dépasser la plateforme quand votre équipe s’agrandit.
Pour découvrir en détail les fonctionnalités de Clay, visitez la University page. Si vous souhaitez en savoir plus sur les cas d’usage de Clay et recevoir des mises à jour régulières, rejoignez la Slack community de la plateforme et sign up for the newsletter. 💌
FAQ
Qu’est‑ce que le scraping de données ?
La collecte de données est un processus automatisé qui extrait des informations de sites web ou d’autres sources numériques pour les importer dans un tableau ou un fichier d’analyse. Des outils spécialisés, appelés extracteurs de données, s’occupent de la tâche en puisant les données de boutiques en ligne, de pages d’entreprise et de plateformes sociales.
Le scraping de données, c’est légal ?
Le scraping de données publiques est généralement légal, à condition de respecter les lois en vigueur et les Conditions générales d’utilisation de chaque site. Scraper des données protégées par le droit d’auteur ou privées sans consentement peut entraîner des problèmes juridiques. Les réglementations varient aussi selon le pays et l’État ; il faut donc toujours vérifier les règles locales avant de scraper.
Quels sont les principaux types de scraping de données ?
Les techniques les plus courantes sont le copier‑coller manuel, l’analyse HTML, l’analyse DOM, l’agrégation verticale, XPath, la reconnaissance optique de caractères (OCR) et les scrapers web dédiés. Les scrapers web sans code restent l’option la plus accessible pour les équipes qui ne maîtrisent pas le code.
Quelle est la différence entre le data scraping et le Web scraping ?
Le web scraping est un sous‑ensemble du data scraping qui cible spécifiquement les sites web. Le data scraping, lui, désigne l’extraction d’informations depuis n’importe quelle source : documents numérisés (via OCR), systèmes hérités, rapports, etc., pas seulement les pages web.